

Imagine o seguinte cenário: hoje é o 5º dia de atraso da fatura de cartão de crédito de um cliente. Pelas regras de negócio do banco, o cartão deveria ser bloqueado automaticamente para impedir novas compras.
No mundo ideal dos diagramas de arquitetura, o fluxo é lindo:
O Core Bancário detecta o atraso.
Um evento
CreditCardOverdueé publicado no barramento.O microsserviço de Cartões consome a mensagem e muda o status para
BLOCKED.
Mas nós somos programadores pragmáticos e sabemos que o mundo real é caótico. E se o consumer de Cartões estiver fora do ar justo nesse milissegundo? E se a mensagem cair numa Dead Letter Quee (DLQ) e for esquecida lá? E se o payload do evento tiver um caractere inválido que quebra o parser (a temida Poison Pill)?
O resultado é o silêncio.
O evento falha, o sistema não tenta de novo, e o contrato entra no que chamamos de State Drift (Desvio de Estado). Para o banco de dados, aquele cliente ainda está ACTIVE. Ele vai ao shopping amanhã e gasta mais R$ 5.000,00. O banco aumentou sua exposição ao risco por uma falha.
Pior ainda: o cenario avança 200 dias. Esse cliente nunca pagou. Pela regulação do Banco Central, esse contrato deveria ser marcado como Prejuízo (Write-off) para fins contábeis e fiscais. Se o seu sistema depende exclusivamente de um evento disparado no dia 200 para fazer isso, e esse evento falha... parabéns, seu banco agora tem um passivo contábil incorreto e está sujeito a multas regulatórias.1
Arquiteturas Orientadas a Eventos são excelentes para escalabilidade e desacoplamento, mas elas não garantem a consistência final dos dados ao longo do tempo.
Para sistemas financeiros críticos, precisamos de mais. Precisamos de uma arquitetura de Self-Healing. Precisamos de sistemas que não apenas “reajam” a eventos, mas que proativamente “busquem e corrijam” estados inconsistentes baseados na passagem do tempo.
Neste artigo, vamos explorar como desenhar uma estratégia robusta de recuperação de estado para ciclos de crédito. Vamos sair do “Happy Path” e desenhar o “Safety Path”: cron jobs inteligentes, máquinas de estado resilientes e estratégias de reconciliação que garantem que, mesmo que o broker pegue fogo, o balanço do banco feche no final do mês.
O que é Self-Healing?
Se você jogou qualquer RPG ou MMO nos últimos 20 anos, o termo “Self-Healing” provavelmente evoca a imagem de um personagem regenerando sua barra de vida automaticamente ou um clérigo lançando um feitiço de cura. No mundo dos jogos, é a mecânica que permite ao jogador continuar na batalha sem precisar parar o tempo todo.
Na engenharia de software, o conceito é surpreendentemente similar, mas a inspiração original não veio dos videogames. Veio da Biologia.
A Biologia como Benchmark
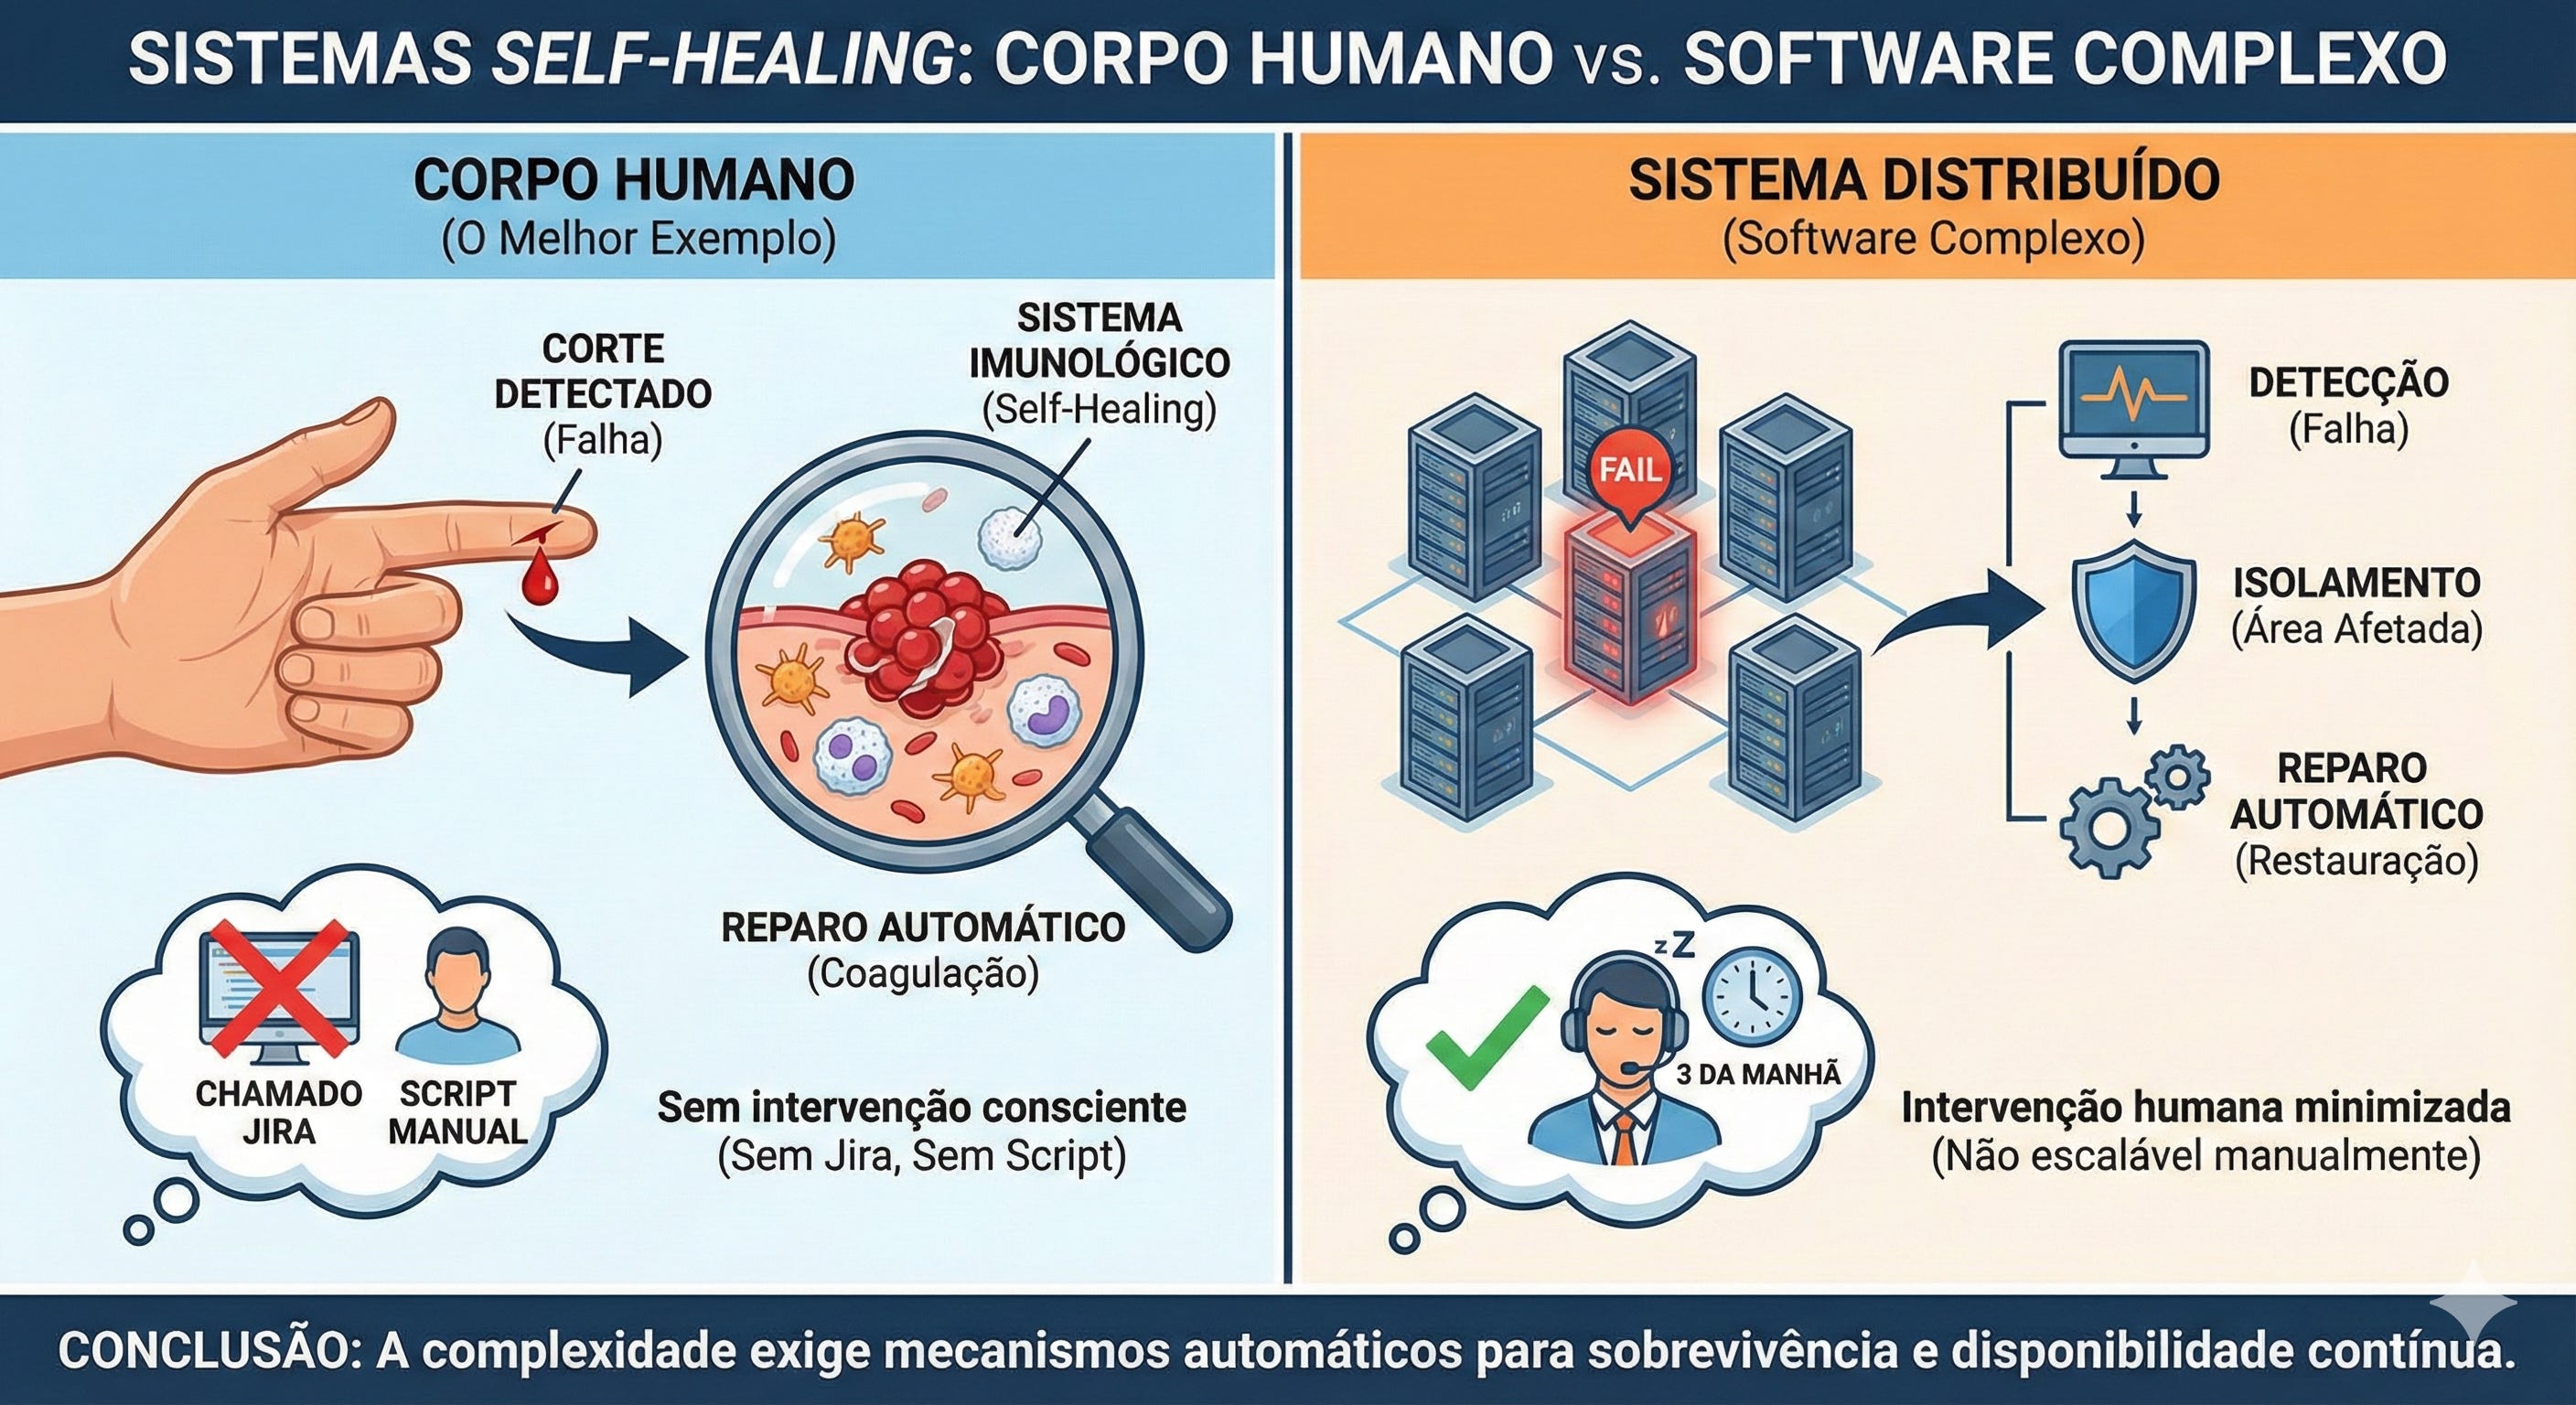
No mundo real, o melhor exemplo de um sistema Self-Healing é o seu próprio corpo. Quando você faz um pequeno corte no dedo, você não precisa abrir um chamado no Jira para o seu cérebro, nem rodar um script manual para iniciar a coagulação. O seu sistema imunológico detecta a “falha” (o corte), isola a área e inicia processos automáticos de reparo para restaurar a integridade da pele.
Se o corpo humano dependesse de intervenção consciente para curar cada micro-lesão, não sobreviveríamos um dia. Sistemas distribuídos complexos chegaram a esse mesmo estágio: eles são grandes demais para serem “curados” manualmente por humanos às 3 da manhã.
O Manifesto da IBM
O termo ganhou força corporativa no início dos anos 2000, quando a IBM lançou seu manifesto sobre Computação Autonômica (Autonomic Computing).
A IBM percebeu que a complexidade dos sistemas de computação estava crescendo mais rápido do que a capacidade humana de gerenciá-los. Eles propuseram que os sistemas deveriam ter quatro propriedades inspiradas no sistema nervoso autônomo:
Self-Configuration: Configurar-se sozinho.
Self-Optimization: Otimizar recursos sozinho.
Self-Protection: Defender-se de ataques.
Self-Healing: Detectar, diagnosticar e reparar problemas causados por falhas internas ou externas.
Portanto, Self-Healing não é apenas “tentar de novo”. É a capacidade de um sistema perceber que não está saudável (está inconsistente) e tomar medidas para voltar ao estado normal sem acordar o engenheiro de plantão.
O “Diagnóstico Financeiro”: Meu sistema precisa de Self-Healing?
Implementar Self-Healing (como jobs de reconciliação de GL, retentativas inteligentes ou estornos automáticos) custa caro. Aumenta a complexidade do código e exige manutenção. Não use um canhão para matar uma mosca.
Para saber se o seu microsserviço financeiro precisa dessa arquitetura, faça a si mesmo estas 4 perguntas (O “Teste da Dor Financeira”):
1. A inconsistência gera impacto no P&L ou risco regulatório?
Contexto: Erros de UI tem um menor impacto; erros de financeiros são fatais.
Exemplo: Se o avatar do usuário não carregar, o máximo que acontece é uma experiência visual ruim. Ninguém processa o banco por isso. Mas o jogo muda quando entramos na camada regulatória: se o cálculo de IOF falhar silenciosamente e você recolher a menos para a Receita, ou se um contrato inadimplente não sofrer a Baixa Contábil (Write-off) no momento exigido pelas normas vigentes (como a Resolução CMN 4.966), você estará mantendo um ativo 'podre' inflando artificialmente o balanço. Nesse cenário, o erro de software deixa de ser um bug no Jira e vira risco de conformidade, colocando na reta não só a reputação da empresa, mas o CPF dos diretores estatutários.
Se o erro afeta o balanço contábil ou relatórios para o regulador (BACEN/CVM), a cura precisa ser automática.
2. A operação manual escala com o volume transacional?
Contexto: O custo do Backoffice vs. Engenharia.
Exemplo: Se 5 TEDs falham por dia, um analista de N2 pode corrigir na mão acessando o banco de dados. Mas se você processa PIX e tem uma taxa de falha de 0.1% em dia de folha de pagamento (milhares de erros/hora), tentar corrigir isso manualmente vai colapsar seu time de atendimento e gerar milhares de reclamações no Banco Central.
Se o volume de falhas excede a capacidade humana de digitar
UPDATEno banco em tempo real, você precisa de automação.
3. O erro gera Passivo Fantasma?
Contexto: O perigo do “Sucesso Falso”.
Exemplo: O sistema de eventos diz que o cartão foi bloqueado, mas o processadora de cartões não recebeu o comando. O cliente continua comprando. Para o seu banco de dados, está tudo certo; para o caixa do banco, há um vazamento de dinheiro invisível ocorrendo agora.
Se o estado financeiro pode divergir da realidade sem gerar um Exception imediato, você precisa de um “Auditor Robô” (Worker) rodando de tempos em tempos.
4. Existe uma Janela de Clearing ou SLA Regulatório Rígido?
Contexto: O tempo não perdoa em finanças.
Exemplo: Você tem até as 16h para enviar a remessa de boletos ou até as 18h30 para fechar o caixa do STR (Sistema de Transferência de Reservas). Se o sistema travar às 15h50, você não tem 20 minutos para esperar um humano investigar logs. O sistema precisa tentar rotas alternativas ou degradar graciosamente para garantir o envio.
Se perder a janela de tempo significa multa ou travar o dinheiro do banco até o dia seguinte, a recuperação deve ser instantânea.
Se o erro permite que você espere até a daily do dia seguinte para resolver, não gaste engenharia com isso. Mas se o erro faz o banco perder dinheiro, inflacionar o balanço artificialmente ou falhar com o BACEN enquanto você dorme, o Self-Healing é obrigatório.
A Auditoria de Inconsistência (Como encontrar os “Fantasmas” no seu Banco)
Se você passou pelo “Teste da Dor” e desconfia que seu sistema precisa de cura automática, o próximo passo não é abrir o VS Code, mas sim abrir o Jira e o seu banco de dados em produção.
Para justificar o investimento em uma arquitetura de Self-Healing para a diretoria, você precisa de dados. A equipe de engenharia deve conduzir uma investigação em três frentes para mapear a fragilidade atual do sistema.
Chamamos isso de “A Caça aos Fantasmas de Estado”.
1. A Análise de “Toil” (Trabalho Penoso)
O conceito de Toil (do SRE do Google) refere-se ao trabalho manual, repetitivo e tático. Peça para o seu Tech Lead ou coordenador de suporte levantar os chamados dos últimos 6 meses. Procure por padrões nos tickets fechados:
A “Pasta Mágica” de Scripts: O time tem uma pasta compartilhada com scripts SQL chamados
update_status_travado.sqloudestravar_pix.sql? Se existe um script oficial para corrigir dados na mão, isso é um grito de socorro por Self-Healing.Tickets de “Sincronia”: Chamados com títulos como “Cliente pagou mas não consta no app” ou “Fatura cancelada ainda aparece como aberta”.
A Regra dos 20%: Se a sua equipe gasta mais de 20% do sprint executando correções manuais de dados (não de código, mas de dados), a automação não é luxo, é sobrevivência.
2. A “Query Caça-Fantasmas” (Data Integrity Probe)
Não espere o cliente reclamar. A engenharia deve executar queries exploratórias para encontrar estados impossíveis que existem silenciosamente no banco de dados hoje.
Crie queries que busquem violações da sua Máquina de Estados:
O Limbo do Processamento:
SELECT count(*) FROM transacoes
WHERE status = 'PROCESSING'
AND created_at < NOW() - INTERVAL '24 HOURS';
Diagnóstico: Em um sistema financeiro, nada deve ficar “processando” por 24 horas. Ou pagou, ou falhou. Se retornou linhas, você tem “fantasmas” que precisam de cura.
O Zumbi Financeiro:
SELECT count(*) FROM contratos
WHERE dias_atraso > 60
AND status = 'ACTIVE';
Diagnóstico: O cliente deve há dois meses e o contrato está ativo? O evento de bloqueio falhou e ninguém viu.
3. O Mapeamento de Dependências Cegas
Desenhe a arquitetura e circule em vermelho todos os pontos onde seu sistema espera passivamente por uma resposta externa.
Webhooks de Pagamento: Se o gateway não chamar o seu webhook de confirmação (ou se o serviço de bloquear), a transação morre?
Arquivos de Retorno (CNAB): Se o arquivo do banco não chegar até as 10h, o processo para?
Se o seu sistema desenhado depende da “sorte” de receber um evento externo e não tem um processo ativo que vai lá perguntar “e aí, já processou?”, você encontrou o ponto exato onde deve implementar o primeiro mecanismo de reconciliação.
O Resultado da Análise
Ao final dessa auditoria, a equipe deve ter uma tabela simples:

Com essa tabela, a decisão deixa de ser técnica (”queremos fazer porque é legal”) e vira financeira (”queremos fazer para recuperar 14 horas de engenharia e destravar R$ 45 mil”).
A Ilusão do "Event-Driven Puro"
Nós, arquitetos e engenheiros de software, fomos seduzidos por uma promessa arquitetural: “Desacople tudo. Use eventos. O sistema será reativo e perfeito.”
Em diagramas de arquitetura, setas ligando o Producer ao Consumer via Kafka ou RabbitMQ representam certeza. Na prática, elas representam esperança. Em sistemas financeiros, especialmente em Cobrança e Crédito, a esperança não é uma estratégia viável.
O Dia 5
Vamos analisar a anatomia de um desastre silencioso. Imagine que seu motor de crédito (Core Banking) dispara o evento PaymentOverdue exatamente no 5º dia de atraso do cliente. A regra de negócio é clara: “Se atrasar 5 dias, bloqueie o cartão imediatamente.”
O evento é publicado. O offset é commitado. O Core Banking “lavou as mãos”, crente de que fez sua parte. Mas do outro lado, no microsserviço de Cartões, o Consumer encontrou um problema:
A “Poison Pill”: O payload do evento veio com um caractere invisível no campo
contract_id, causando uma Exception de deserialização que trava o processamento daquele lote.Falha de Infra: O pod do Kubernetes estava reiniciando por OOM (Out of Memory) bem naquele segundo.
Bug Silencioso: O código consumiu a mensagem, mas falhou ao gravar no banco devido a um Deadlock, e a configuração de retry estava mal implementada.
O Resultado é que o evento se perdeu. Para o sistema, o cliente ainda está “Ativo”. Para o cliente, o cartão continua passando na maquininha.
PDD e Metas Estouradas
Aqui é onde o código afeta o bônus da diretoria e a saúde do banco.
Passam-se 6, 7, 8 dias. O cliente, que já não pagou a fatura anterior, continua comprando (aumentando a exposição do banco ao risco). Chamamos isso de Exposição Sombra. O sistema de Risco acha que a exposição é X, mas ela é X + R$ 5.000,00 que o cliente gastou depois do dia em que deveria ter sido bloqueado.
Quando o time de dados rodar o relatório mensal de PDD (Provisão para Devedores Duvidosos) ou PCL, os números não baterão.
Impacto no Time: Sua squad para de desenvolver features novas. O Sprint vai para o lixo. Vocês entram em “War Room” para fazer queries manuais no banco, tentando descobrir quais clientes deveriam estar bloqueados e não estão.
Impacto na Meta: O tempo gasto investigando “fantasmas” (incidências sem logs de erro óbvios) é exponencialmente maior do que corrigir um bug que estoura um alerta 500 no Datadog.
Arquiteturas puramente orientadas a eventos sofrem de um otimismo excessivo. Elas assumem que a mensagem vai chegar.
Para dormir tranquilo, precisamos adotar uma postura pessimista: “O evento vai falhar. E quando ele falhar, quem vai limpar a bagunça?”
Eventos são excelentes para Real-Time (velocidade). Mas Jobs de Varredura são necessários para Consistência (garantia).
Se o evento é o carteiro que entrega a conta, precisamos de alguém que passe depois verificando se a conta foi realmente paga. Precisamos de um “Varredor de Estados”.
O "State Sweeper" – A Rede de Segurança Invisível
O que exatamente é esse “State Sweeper” (Varredor de Estado)?
Em uma definição simples:
O State Sweeper é um componente arquitetural proativo que periodicamente interroga a base de dados em busca de inconsistências temporais ou lógicas que escaparam do fluxo padrão de eventos.
Enquanto a arquitetura orientada a eventos (EDA) é Reativa (o sistema espera algo acontecer para agir), o State Sweeper é Proativo (o sistema vai verificar se algo deveria ter acontecido, mas não aconteceu).
Por que ele é obrigatório em Event-Driven?
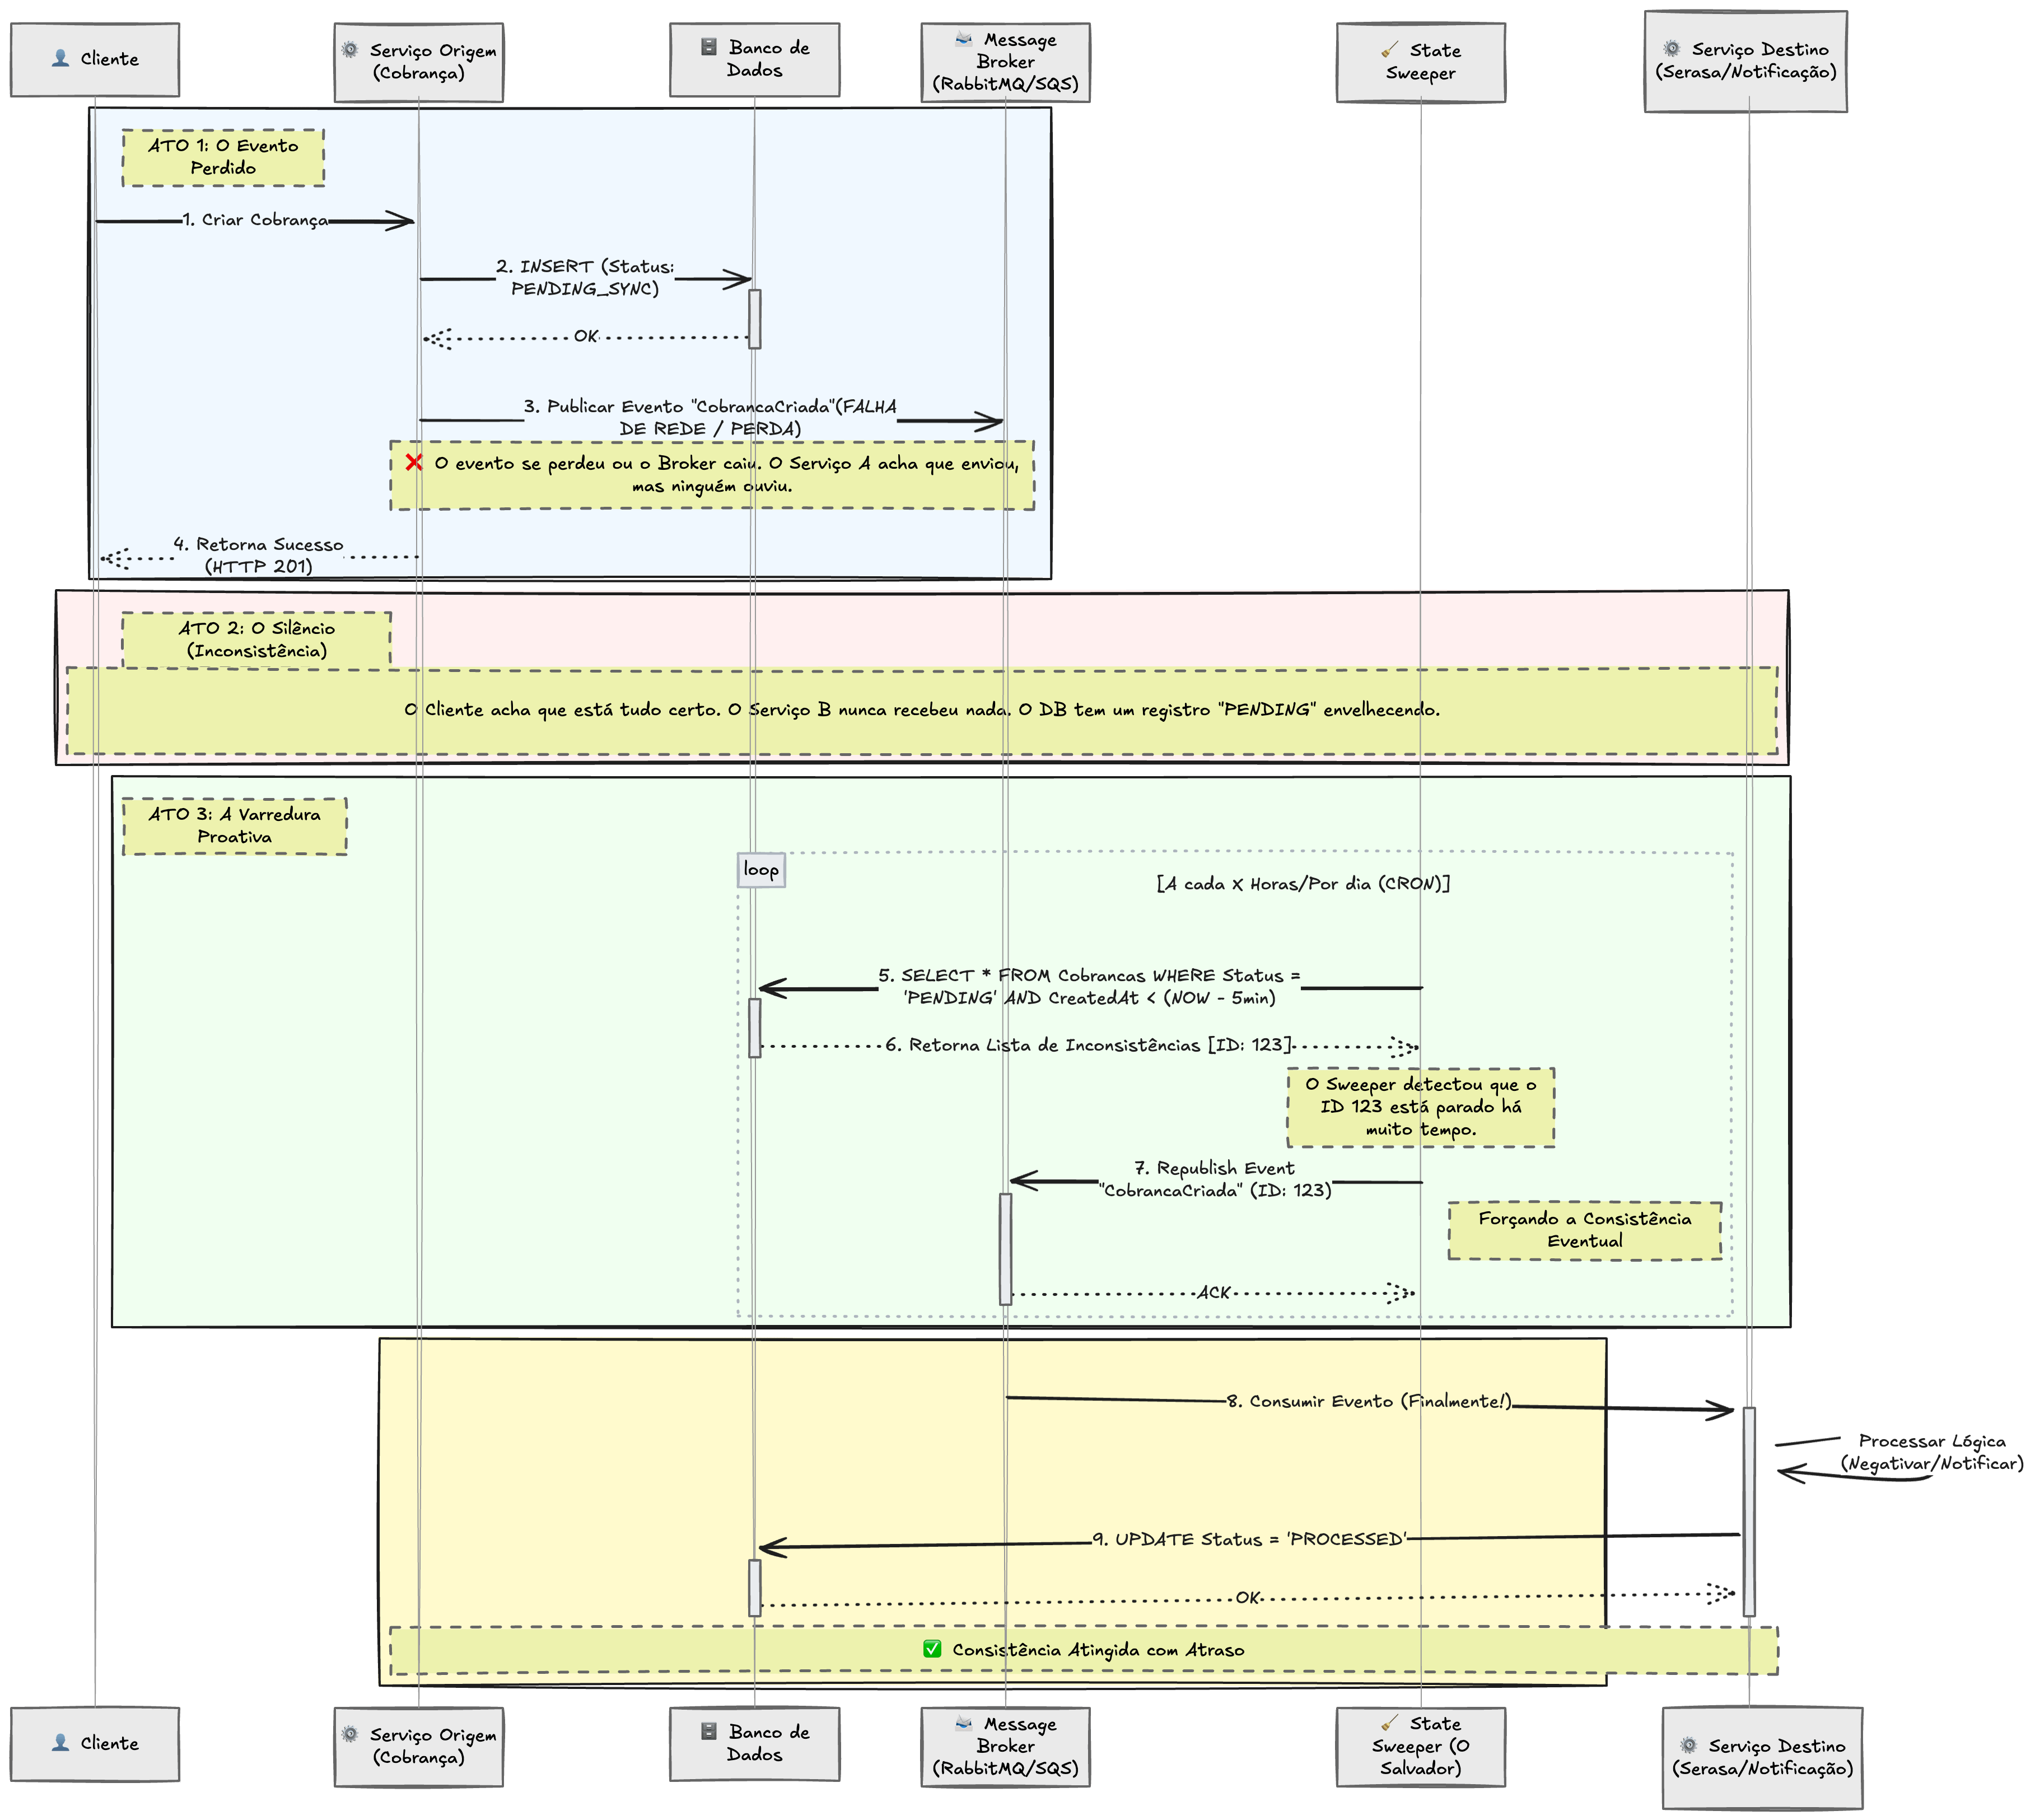
Nós amamos arquiteturas orientadas a eventos porque elas desacoplam serviços. O Serviço A grita “Cobrança Criada!” e não se importa com quem vai ouvir.
Mas essa liberdade tem um custo: O Silêncio. Se o evento se perde, ou se o consumidor falha silenciosamente, não há “erro”. Há apenas o vazio. O sistema não quebra; ele simplesmente para de evoluir o estado daquele contrato.
O cliente não é bloqueado.
A divida não é transmitida para outros serviços.
O nome não vai para o Serasa.
O State Sweeper é necessário porque ele não confia na infraestrutura de mensageria. Ele confia apenas na passagem do tempo e no estado persistido. Ele é a garantia final de que a “Consistência Eventual” vai realmente acontecer, mesmo que seja “na marra”.
A Complexidade Oculta: Por que é difícil desenvolver?
Muitos gerentes podem olhar para isso e dizer: “Ah, é só uma rotina que roda a cada diariamente, pede para o estagiário fazer.”
Isso é um grande engano! Desenvolver um Sweeper eficiente e seguro exige um nível de pensamento crítico e análise de negócio que geralmente só encontramos em engenheiros sêniores ou especialistas.
Por que não é simples?
1. Exige Domínio Absoluto das Regras de Negócio Você não pode escrever um Sweeper se não entender profundamente o ciclo de vida da entidade. ⚠️
Pergunta Difícil: “Se o contrato está atrasado há 200 dias, eu devo mandar para cobrança externa? Mas e se ele tiver uma flag de ‘Renegociação em Andamento’? E se for um dia não-útil? E se o cliente tiver uma liminar judicial?”
O Sweeper toma decisões. Se a regra estiver errada, ele vai aplicar a regra errada em massa (ex: bloquear 50 mil clientes indevidamente em 1 minuto).
2. O Dilema da Concorrência (Race Conditions) E se o Sweeper rodar exatamente no mesmo milissegundo em que o evento real chegou atrasado?
Você precisa desenhar mecanismos de travamento (Locks) ou verificações de versão (Optimistic Locking) para garantir que o Sweeper e o Consumer não tentem modificar o mesmo contrato ao mesmo tempo, corrompendo o saldo.
3. O Perigo da “Avalanche” Se o seu sistema ficar fora do ar por 2 horas, você acumulará milhares de pendências.
Um Sweeper mal desenhado vai tentar corrigir tudo de uma vez assim que o sistema voltar, criando um ataque DDoS contra o seu próprio banco de dados ou contra as APIs de parceiros. É preciso desenhar backoff, paginação e limitação de taxa (throttling).
4. Visibilidade e Rastreabilidade Quando um humano corrige um erro, ele deixa um log. Quando um robô corrige 500 erros, quem fica sabendo?
Desenvolver um Sweeper exige criar eventos específicos (ex:
ContractAutoHealed) para que os analistas saibam a diferença entre “O sistema funcionou normalmente” e “O sistema falhou, mas o robô consertou”.
O State Sweeper não é um “tapa-buraco”. É um componente de Resiliência de Negócio. Ele exige que a equipe de engenharia pare de pensar apenas em código (syntax) e comece a pensar em comportamento sistêmico (semantics) e modos de falha.
System Design com Sweepers em Arquiteturas Distribuídas
Aqui chegamos ao “nó” arquitetural que separa os juniores dos seniores.
No mundo monolítico, o Sweeper seria um script simples que atualizaria todas as tabelas. Mas nós estamos no mundo dos Microsserviços. O Serviço de Cobrança (Collection Service) é a autoridade sobre quem está sendo cobrado, mas ele não é o dono do Contrato de Crédito original (quem manda lá é o Credit Core).
Isso cria um dilema: O Serviço de Cobrança sabe que o cliente está atrasado há 205 dias (violando a regra de negócio de 200 dias), mas ele não pode simplesmente dar um UPDATE na tabela do Core.
Então, como desenhar um Sweeper que impõe a regra sem quebrar o desacoplamento? A resposta está em atuar como um Auditor Ativo.
O Cenário: A Regra dos 200 Dias
A regra é clara: “Contratos com mais de 200 dias de atraso devem ser retirados da carteira interna e enviados para uma Assessoria de Cobrança Externa (Recovery).”
Se o evento do “Dia 200” falhar, o contrato fica esquecido na base de Cobrança com status OVERDUE. O banco perde dinheiro a cada dia.
Passo 1: A Detecção Cirúrgica (NoSQL Strategy)
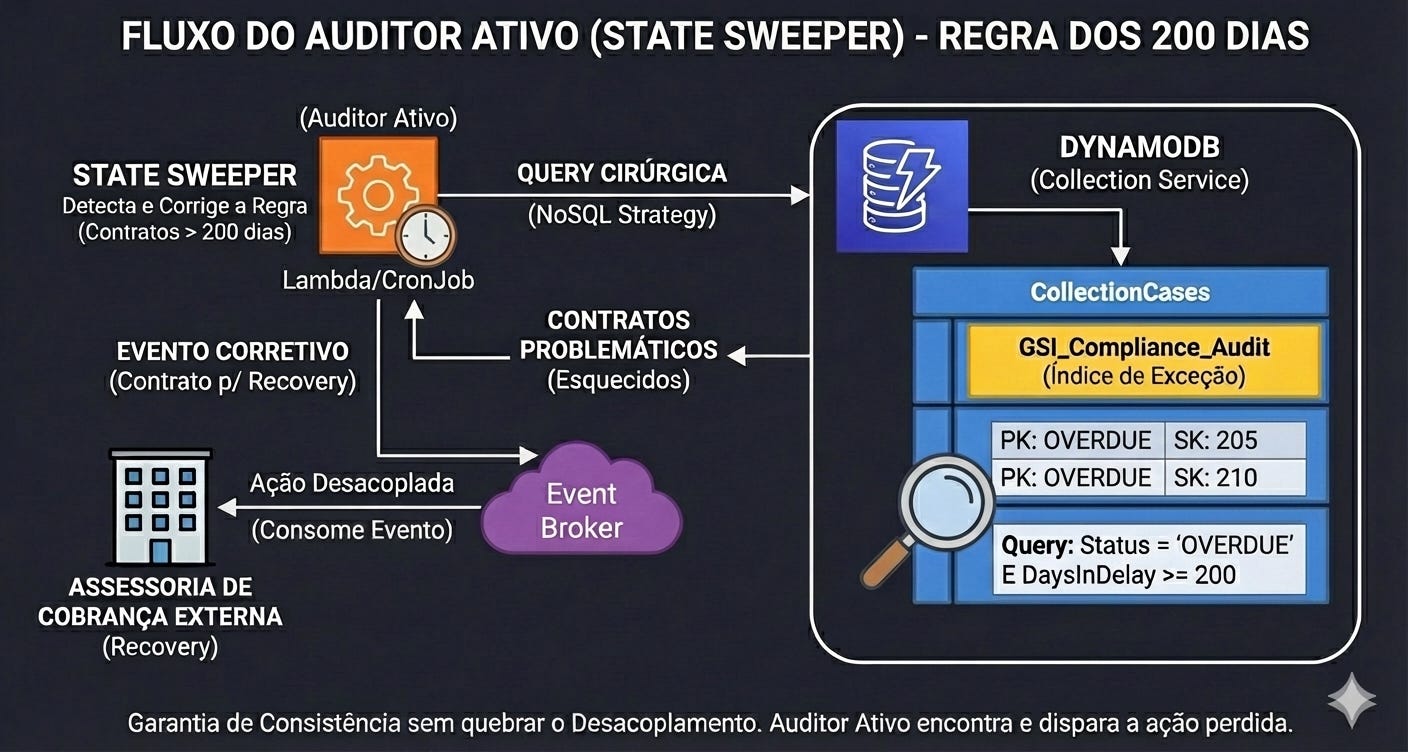
Primeiro, o Sweeper (um Lambda ou CronJob) precisa encontrar os infratores na sua própria base (Collection Service). Não vamos fazer Scan. Vamos usar a estratégia de Índice de Exceção no DynamoDB.
Tabela:
CollectionCasesGSI (Índice):
GSI_Compliance_AuditPK:
CollectionStatus(Ex:OVERDUE)SK:
DaysInDelay(Numérico)
A Query do Sweeper: Ele pergunta ao DynamoDB: “Liste apenas os itens onde Status = ‘OVERDUE’ E DaysInDelay >= 200”. Isso é extremamente performático. Se o sistema estiver saudável, retorna zero. Se houver falha no fluxo de eventos, retorna exatamente os contratos problemáticos.
Passo 2: O “Sanity Check” (Consulta de Segurança)
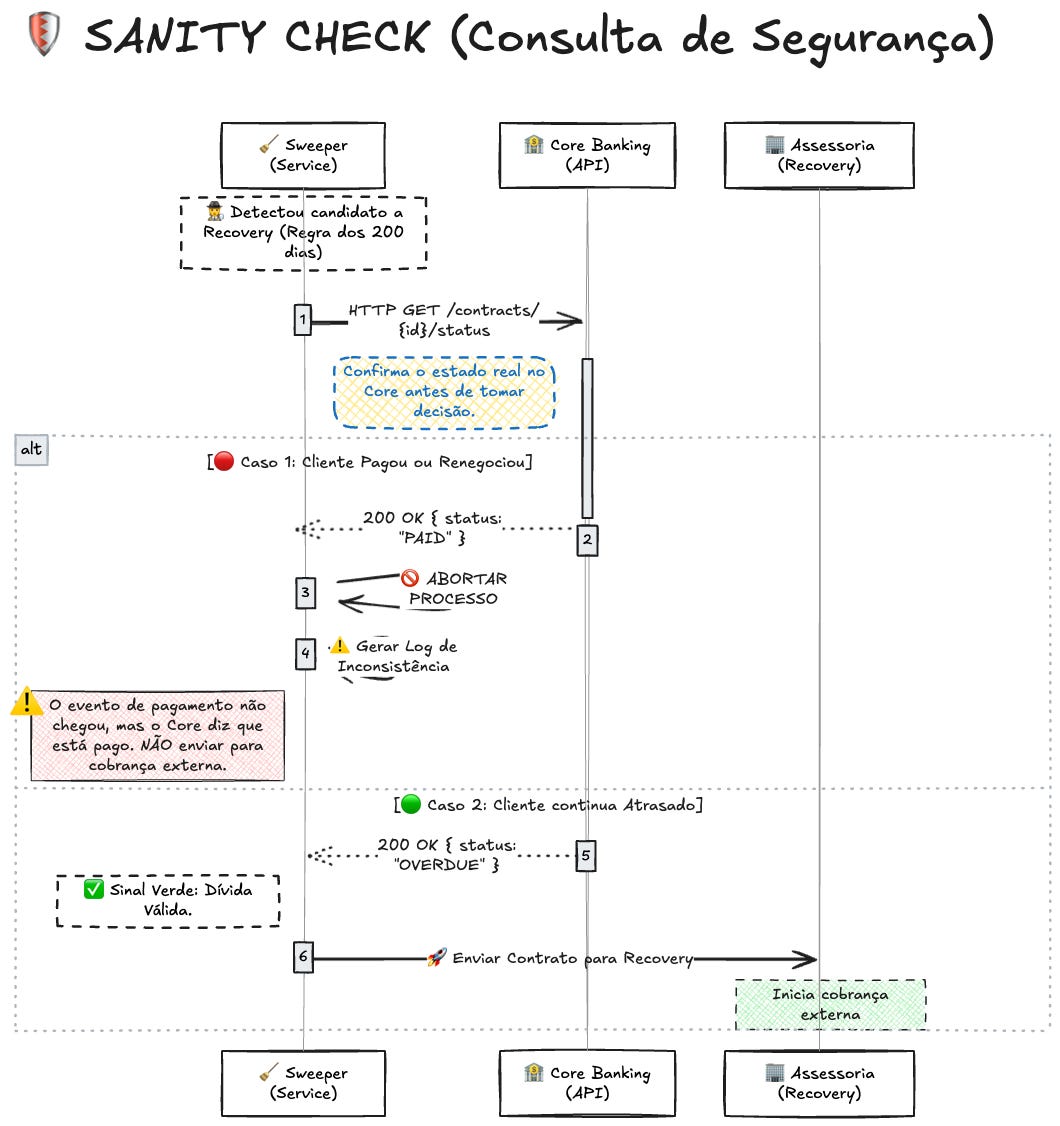
Aqui entra a inteligência distribuída. Antes de tomar uma atitude drástica, o Sweeper precisa garantir que sua visão de mundo não está distorcida. Pode ser que o cliente tenha renegociado a dívida no Core há 10 minutos e o evento de “Renegociação” ainda não chegou na Cobrança.
O Sweeper faz uma chamada síncrona leve (HTTP GET) na API do Core: GET /credit-core/contracts/{id}/status
Se o Core disser “Renegociado/Pago”: O Sweeper aborta e dispara um alerta de inconsistência de dados (para corrigir sua base local depois).
Se o Core disser “Atrasado”: O sinal verde está dado. A regra dos 200 dias foi violada e a dívida é válida.
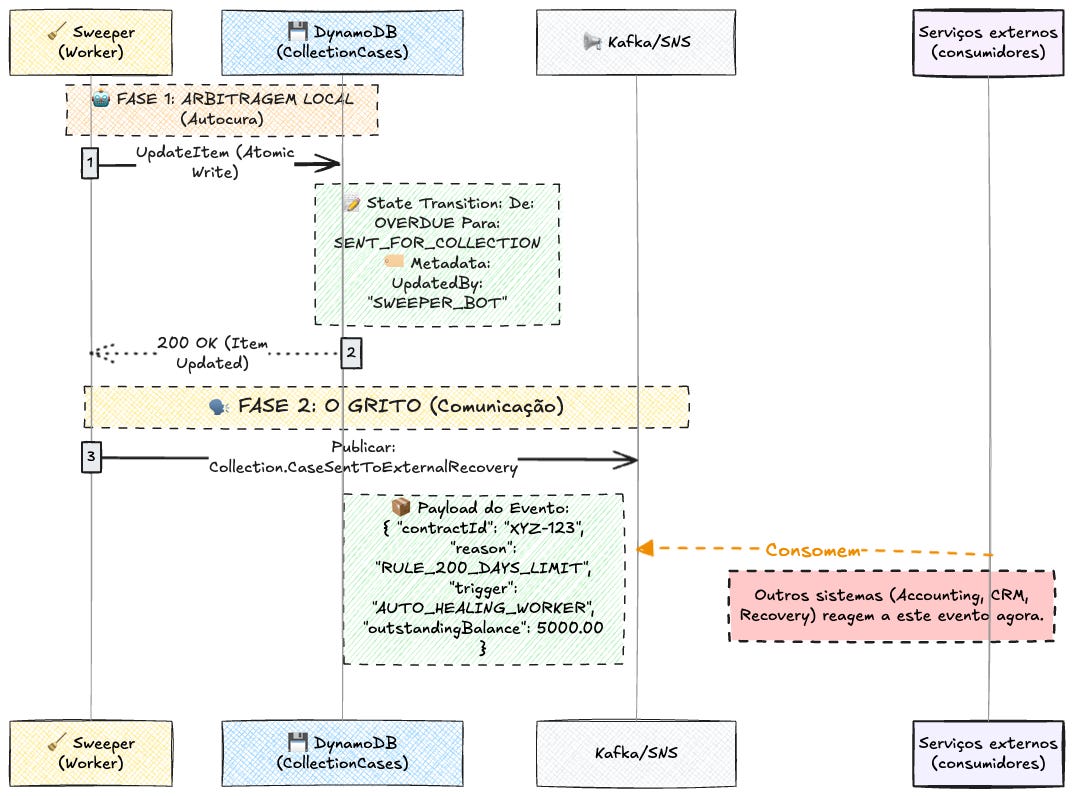
Passo 3: A “Arbitragem Local” e o Disparo do Evento
O Sweeper não ordena que o Core mude. Ele ordena que o Serviço de Cobrança tome a atitude correta para proteger o banco.
Atualização da Base Local (Autocura): O Sweeper executa um
UpdateItemna tabelaCollectionCases:De:
OVERDUEPara:
SENT_FOR_COLLECTIONMetadata: Adiciona um campo
UpdatedBy: "SWEEPER_BOT"para rastreabilidade.
Comunicação ao Ecossistema (O Grito): Como o contrato mudou de estado, o Serviço de Cobrança precisa avisar o mundo. Ele publica um evento enriquecido no barramento (Kafka/SNS):
Evento:
Collection.CaseSentToExternalRecovery
{
  "contractId": "XYZ-123",
  "daysInDelay": 205,
  "outstandingBalance": 5000.00,
  "reason": "RULE_200_DAYS_LIMIT",
  "trigger": "AUTO_HEALING_WORKER", // Campo crucial para métricas!
  "occurredAt": "2024-01-20T10:00:00Z"
}
O Resultado Arquitetural
Veja a elegância dessa solução:
Respeito aos Limites: O Serviço de Cobrança não invadiu o Core. Ele resolveu o problema do seu lado (mudou para
SENT_FOR_COLLECTION) e avisou os parceiros.Integração Reativa: Quando a Assessoria de Cobrança escutar esse evento, ela cadastra a dívida lá. Quando o Core escutar esse evento, ele marca o contrato como “Em Prejuízo”.
Observabilidade: Graças ao campo
trigger: AUTO_HEALING_WORKER, você pode criar um dashboard no Datadog/Grafana. Se o número de eventos disparados pelo Sweeper subir, você sabe que seu fluxo real-time (Kafka) está quebrado, antes mesmo do Diretor reclamar.
O Sweeper aqui não é um “consertador de banco de dados”. Ele é um agente de negócio automatizado que garante que as regras financeiras sejam cumpridas, mesmo quando a infraestrutura falha.
Antes do Código: A Mentalidade Orientada a Perguntas
Agora que você viu uma ponta do Self-Healing em ação, pare um pouco. Antes de abrir a IDE e começar a codar Lambdas ou desenhar índices no DynamoDB, você precisa de algo que nenhuma ferramenta pode te dar: Contexto de Negócio.
Uma arquitetura de autocura não nasce de requisitos técnicos, ela nasce de dores operacionais. Para modelar os dados corretamente e facilitar a introdução dessas rotinas de cura, Tech Leads e Arquitetos precisam adotar uma postura de investigação.
1. A Mina de Ouro: O Time de Suporte (N1/N2)
Se você quer saber onde seu sistema sangra, não olhe para o Datadog agora. Olhe para a fila de chamados. O time que atende o cliente provavelmente já tem uma “Wiki” ou um caderno de anotações com procedimentos manuais para resolver problemas que a engenharia considera “pontuais”, mas que na verdade são crônicos.
Você precisa se perguntar:
“Por que o atendente precisa verificar manualmente se a fatura do dia 15 fechou?”
“Quais scripts o time de Operações roda toda sexta-feira para ‘ajustar a base’?”
“Quantas vezes um cliente ligou reclamando que pagou o acordo, mas continua recebendo SMS de cobrança?”
Cada um desses “procedimentos manuais” é um candidato a automação via Self-Healing. O Sweeper nada mais é do que a codificação do conhecimento tático do time de suporte, rodando 24/7.
2. O Custo da Inconsistência (O Risco Jurídico)
Estados inconsistentes em sistemas financeiros não são apenas “bugs”. São passivos judiciais.
Cobrança Indevida: Um cliente que renegociou a dívida, mas o evento se perdeu e ele voltou para a régua de cobrança, é um processo ganho no Juizado de Pequenas Causas.
Bloqueio Indevido: Um cartão bloqueado porque a fatura consta em aberto (quando já foi paga) gera uma experiência terrível e danos morais.
O objetivo do Self-Healing é mitigar esse risco. É garantir que a realidade do cliente (ele pagou) seja igual à realidade do sistema (o status é PAID), independente de falhas na rede. Inconsistência é inaceitável.
3. Access Patterns: Seja Orientado a Perguntas
Aqui entra a virada de chave mental. Para criar um sistema que se cura, você precisa modelar seus dados baseado nas perguntas de auditoria, não apenas nas perguntas de navegação.
Não adianta apenas perguntar: “Como recupero o contrato do cliente X?”. Você deve perguntar: “Como o sistema identifica, em meio a 10 milhões de contratos, quais deveriam ter fechado ontem e não fecharam?”
Se você não tiver essa resposta na ponta da língua (e modelada no seu banco de dados), você não tem observabilidade, você tem cegueira.
Se o negócio diz: “Faturas acima de R$ 5k não podem ficar abertas por mais de 30 dias”, sua arquitetura deve responder à pergunta: “Onde estão as faturas > 5k com days_delayed > 30?” de forma instantânea.
O sucesso do Self-Healing depende 20% de tecnologia (Lambdas, Streams, Queues) e 80% de entender profundamente as regras de negócio para converter “Dores de Suporte” em “Consultas de Auditoria”.
Conclusão
Há uma verdade desconfortável que todo Tech Lead aprende eventualmente: em sistemas distribuídos, a esperança não é uma estratégia de engenharia.
Nós gastamos horas desenhando diagramas perfeitos no Miro, onde setas conectam microsserviços em uma dança sincronizada. Mas em produção, redes oscilam, brokers engasgam, deploys introduzem bugs e parceiros externos ficam fora do ar. A entropia sempre vence.
A arquitetura de Self-Healing não é sobre construir sistemas que nunca falham; isso é impossível. É sobre construir sistemas que falham com elegância e se recuperam com autonomia.
Ao adotar essa estratégia no seu ciclo de crédito e cobrança, você muda o jogo:
Tecnicamente, você para de tratar inconsistências de dados como “incidentes de suporte” e passa a tratá-las como um estado esperado que o próprio software resolve.
Culturalmente, você força sua equipe a sair do piloto automático do “Happy Path” e a desenvolver uma obsessão saudável pelos padrões de acesso e pelas regras de negócio.
Financeiramente, você protege o ativo mais valioso do banco: a integridade do balanço e a conformidade regulatória.
Implementar Sweepers, garantir idempotência e desenhar para a falha dá trabalho. Exige mais código, mais testes e mais infraestrutura. Mas o retorno desse investimento é a moeda mais valiosa para quem opera sistemas críticos: a tranquilidade.
É a diferença entre ser acordado às 3 da manhã porque “o fechamento não bateu” ou chegar no escritório às 9h, abrir o dashboard e ver que o sistema detectou 50 falhas durante a madrugada — e corrigiu todas elas sozinho, enquanto você dormia.
No fim do dia, programar para o sucesso é fácil. O que separa os sistemas frágeis dos resilientes é o quanto nos preparamos para o inevitável fracasso.
Nota sobre Regulação Bancária e Risco de Compliance: No Brasil, a classificação de risco de crédito e o provisionamento (PDD) são regidos historicamente pela Resolução CMN 2.682/1999, que determina o nível de provisão com base nos dias de atraso (ex: atrasos superiores a 180 dias exigem provisionamento de 100%). Mais recentemente, a Resolução CMN 4.966/2021 (vigente a partir de 2025 para a maioria das instituições) alinhou as normas locais ao padrão internacional IFRS 9, focando na “Perda Esperada”. Falhas sistêmicas que impeçam o reconhecimento contábil desses estados violam a integridade das demonstrações financeiras, sujeitando a instituição a multas administrativas severas (conforme Lei nº 13.506/2017) e exigências de capital adicional por Risco Operacional.
esses cenários são impossíveis se você usar técnicas básicas como normalize no payload, outbox e CDC
A “Poison Pill”: O payload do evento veio com um caractere invisível no campo contract_id, causando uma Exception de deserialização que trava o processamento daquele lote.
Falha de Infra: O pod do Kubernetes estava reiniciando por OOM (Out of Memory) bem naquele segundo.
Bug Silencioso: O código consumiu a mensagem, mas falhou ao gravar no banco devido a um Deadlock, e a configuração de retry estava mal implementada.
O Resultado é que o evento se perdeu. Para o sistema, o cliente ainda está “Ativo”. Para o cliente, o cartão continua passando na maquininha.
1) o mínimo eh limpar todas as propriedades, principalment6e se vvc vai mandar pra LLM, cair nesse prompt injection é pq nunca usou LLM, só limpar com a regex /[\p{Cc}\p{Cf}]/gu
2) se meu UbiQ não receber1 ACK em 10s ele re-emite, mas eu rodo 2 servidores clones de forma concorrente, porra o cara ta dando exemplo de sistema financeiro e não rodar um replica em tempo real já da pra imaginar o sistema
3) se não gravou no banco o CDC não emitiu o evento, meu DataAgent deixa os eventos em Outbox até receber o evento colnfrimando a mudança no banco. Eu não acredt[ito q alguem cairia nesses erros fazendo sistema financeiro, me recuso a acreditar
Você nem citou Eventsourcing que é obrigatório pois é a ÙNICA fonte da verdade e única forma REAL de auditoria e também não citou nenhuma SAGA para possível self-healing, tirando apenas esses pontos eu fiquei muito feliz de ler 1 artigo de Self-healing que não é DevOps, o conceito que evangelizo desde o ano passado não é para o cenário, é para corrigir as intenções dos usuários que chegam no servidor: Intent-basead Healing
Esse comportamento do Sweeper eu possuo no Agent que fica escutando todos eventos necessário, minha arquitetura é coreografada, como assim o Evento falhar? Não gasta criar um GC rodando diariamente emitindo 1 evento por cada registro achado.
Na minha arquitetura 1 outro Agent não atua no outro, o comportamento do Sweeper é de um SubAgent da camada de Domínio e cada evento q receber ele executa seu comportamento. Fora isso você ta de parabéns
Post do mais alto nível, adorei!
Em sistemas distribuídos eu tenho utilizado bastante os patterns de mensageria do livro Enterprise Integration Patterns (EIP), mas não conhecia sobre essa tática de criação de Sweepers. O que chega mais perto do que vc desenhou é o pattern Request/Reply na minha visão, mas ele não é proativo como o Sweeper descrito no seu post, ele ainda ficaria esperando a resposta.