

Cache é, ao mesmo tempo, uma das ferramentas mais poderosas e uma das mais mal utilizadas em engenharia de software. Resolve problemas reais de latência e custo — e, usado sem critério, cria bugs silenciosos que só aparecem em produção, sob carga, no pior momento possível. Este artigo é sobre saber a diferença.
De onde nasceu a ideia de cache (uma breve viagem à CPU)
Em termos simples
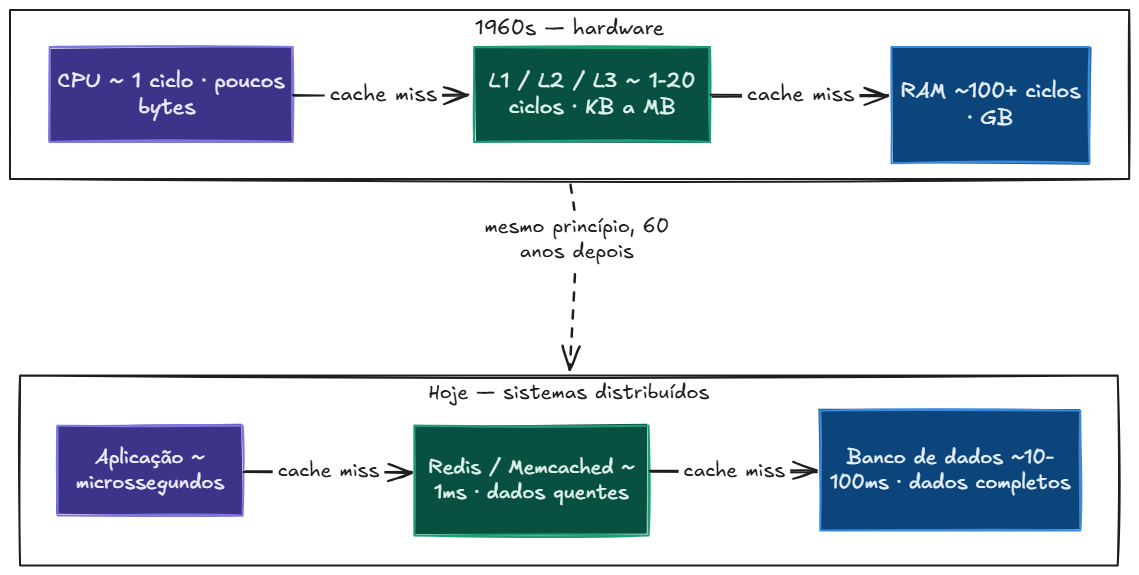
O processador do seu computador é absurdamente mais rápido que a memória RAM que alimenta ele de dados. É como ter um leitor que devora uma página por segundo, mas cujo bibliotecário pessoal leva vários segundos para trazer cada página nova.
O cache não nasceu em nenhum banco de dados nem em nenhum framework web — nasceu na arquitetura de hardware, nos anos 60, para resolver exatamente esse gargalo de velocidade entre processador e memória. A solução foi guardar uma cópia dos dados mais usados numa memória menor, mais cara e muito mais rápida, fisicamente mais perto do processador — o que hoje chamamos de L1, L2 e L3 cache, cada nível um pouco maior e um pouco mais lento que o anterior, até chegar na RAM.
O ponto-chave para carregar deste tópico: o problema que resolvemos hoje com Redis na frente de um banco de dados é, estruturalmente, o mesmo problema que engenheiros de hardware resolveram sessenta anos atrás. Muda a escala, muda o vocabulário, mas a ideia central — guardar uma cópia rápida perto de quem precisa, para não pagar o preço de buscar na fonte lenta toda vez — é a mesma.
Cache no mundo real: a mesa do desenvolvedor e a estante de livros
Em termos simples
Ir até a biblioteca (o banco de dados) buscar um livro toda vez que você precisa de uma informação é lento — tem que se levantar, caminhar, procurar na estante, voltar. Deixar o livro aberto na sua própria mesa de trabalho (o cache) é rápido: a informação já está ali, ao alcance da mão.
A analogia é boa justamente porque o problema dela também é real. Se a sua mesa acumula livros demais, você perde espaço e se confunde sobre qual livro tem qual informação — o equivalente a um cache sem política de despejo, crescendo sem limite. E existe um risco mais sutil: você pode estar lendo, na sua mesa, uma edição desatualizada de um livro, enquanto a biblioteca já recebeu a edição nova. É exatamente isso que chamamos de dado obsoleto (stale data) — e é o problema mais difícil de resolver em qualquer sistema de cache, porque a mesa não avisa sozinha quando o livro dela ficou velho.
Por que dado obsoleto é o bug mais traiçoeiro que existe
Vale se demorar aqui, porque stale data tem uma característica que nenhum outro tipo comum de bug tem: ele não gera erro nenhum. Não lança exceção, não aparece em log de falha, não derruba requisição nenhuma. Ele só entrega, com toda a confiança de uma resposta bem-sucedida, um dado que já deixou de ser verdade. Um sistema servindo dado obsoleto parece, de fora, exatamente tão saudável quanto um sistema servindo dado correto — a única forma de perceber a diferença é comparar com a fonte da verdade, coisa que ninguém faz em toda requisição, porque isso anularia o próprio propósito de ter cache.
Pontos de atenção que todo programador precisa carregar
1. A janela entre escrever e invalidar não é instantânea
Existe sempre um intervalo de tempo — que pode ser milissegundos, mas existe — entre o momento em que o banco confirma a escrita e o momento em que a chave correspondente é de fato removida do cache. Qualquer leitura que aconteça exatamente nesse intervalo recebe o dado antigo, mesmo que a escrita já tenha sido concluída com sucesso.
2. Nem todo caminho de escrita passa pelo mesmo lugar
Um job em lote, uma migração manual rodada direto no banco, uma correção feita por outra squad em outro serviço — qualquer escrita que não passe pelo caminho de código “oficial” da aplicação simplesmente não sabe que precisa invalidar cache nenhum. O dado muda na fonte, e o cache nunca fica sabendo.
3. Cache em camadas múltiplas multiplica o problema
CDN, cache do navegador, cache da aplicação, cache de query do próprio banco — é comum ter várias camadas de cache empilhadas, cada uma com sua própria janela de expiração. Invalidar a camada de aplicação não invalida a CDN; o usuário pode continuar vendo dado velho mesmo depois de o seu código ter feito tudo certo.
4. Cache distribuído nem sempre invalida em todo lugar de uma vez
Em arquiteturas com múltiplas instâncias, múltiplas regiões ou réplicas de cache, invalidar uma chave numa instância não garante que ela também sumiu nas outras — dependendo da topologia, pode existir um atraso de propagação, e diferentes usuários, batendo em réplicas diferentes, veem respostas diferentes ao mesmo tempo.
5. Teste normal quase nunca revela o problema
Um teste automatizado típico faz uma escrita, espera, depois lê — sequencialmente, sem concorrência real. Isso nunca exercita a janela de corrida que causa stale data em produção, porque produção tem múltiplas requisições concorrentes que o teste, sozinho, não reproduz. “Passou nos testes” não é evidência de que a invalidação está correta sob carga real.
Nenhum desses pontos significa que stale data é impossível de mitigar — significa que ele nunca é resolvido por uma única linha de código chamando invalidar(). Exige pensar, para cada dado cacheado, em todos os caminhos que podem mudá-lo, em todas as camadas onde uma cópia dele pode estar guardada, e em quanto tempo de inconsistência o negócio realmente tolera.
O que o cache é (e o que ele definitivamente NÃO é)
Cache é uma camada temporária, volátil e de altíssima velocidade para dados de leitura frequente. Essa definição é curta de propósito — porque a parte mais importante deste tópico está no que ele não é, e que engenheiros sob pressão de prazo tendem a esquecer.
✓ O que ele é
Uma camada temporária e volátil — pode desaparecer, e a aplicação precisa sobreviver a isso.
Otimizado para leitura de altíssima frequência sobre dado que muda pouco.
Uma cópia — nunca a fonte da verdade.
✗ O que ele não é
Não é banco de dados primário — nunca use para persistência crucial que não pode simplesmente sumir.
Não é solução para query ruim ou índice faltando — cache esconde o sintoma, não cura a causa.
Não é remédio para código lento — mascarar latência de algoritmo ineficiente com cache é só acumular débito técnico com juros.
Vale grifar o segundo item da coluna o que ele não é, porque é o erro mais comum e mais caro: colocar um cache na frente de uma query lenta resolve o sintoma imediatamente e esconde o problema real por meses — até o dia em que o cache expira no pior momento possível, e a query lenta original volta a bater, sem aviso, direto na cara de todo mundo.
Os 5 grandes benefícios do cache
O lado bom:
1. Redução drástica de latência
Respostas na casa dos milissegundos, às vezes sub-milissegundos — uma diferença de ordem de magnitude frente a uma consulta que precisa tocar disco.
2. Alívio de carga no banco de dados
Libera conexões e CPU do banco principal, deixando mais capacidade disponível justamente para as operações de escrita, que não têm como ser cacheadas da mesma forma.
3. Economia de custo de infraestrutura
Menos processamento repetitivo em instâncias pagas por hora ou por uso — cada leitura evitada no banco é, literalmente, dinheiro que deixou de ser gasto.
4. Maior vazão (throughput)
O sistema suporta muito mais requisições simultâneas, porque a maioria delas nunca chega a competir pelos mesmos recursos escassos do banco.
5. Resiliência parcial
Em alguns cenários, se o banco primário oscilar, o cache ainda consegue servir leituras temporárias — um amortecedor, não uma garantia, mas que já evitou muita indisponibilidade total.
Os 5 perigos mortais do cache (a parte que dói em produção)
O lado ruim:
Esta é a seção que a comunidade sênior mais valoriza — não porque os perigos sejam segredo, mas porque só quem já apanhou de cada um deles em produção sabe o quanto eles doem na prática.
1. Invalidação de cache — “a coisa mais difícil da computação”
Manter o dado do cache sincronizado com a fonte da verdade é, de forma consolidada na indústria, um dos problemas mais difíceis de acertar de verdade. Não é falta de biblioteca ou de padrão — é que “quando exatamente esse dado deixou de ser válido” é uma pergunta genuinamente difícil quando múltiplos caminhos de escrita podem afetar o mesmo dado cacheado.
2. Cache Stampede / Thundering Herd
Quando um item muito acessado expira, e milhares de requisições simultâneas — que estavam todas contando com aquele cache — batem direto no banco de dados ao mesmo tempo, tentando repopular a mesma chave. O banco, que estava tranquilo um segundo antes, recebe um pico brutal e pode simplesmente cair.
3. Inconsistência de dados (stale data)
O usuário atualiza o próprio perfil, mas continua vendo os dados antigos na tela seguinte — porque a chave de cache correspondente não foi invalidada no momento da escrita. É o bug mais confuso de explicar para um usuário, porque para ele parece que o sistema simplesmente “esqueceu” o que ele acabou de fazer.
4. Consumo descontrolado de memória (OOM)
Salvar payloads gigantescos no cache, sem uma política clara de despejo (como LRU — descartar o item menos recentemente usado), transforma uma ferramenta de otimização em uma bomba-relógio de Out Of Memory esperando o momento certo para explodir.
5. Acoplamento e ponto único de falha
Tratar o servidor de cache como infalível é o erro mais silencioso da lista. Quando ele cai — e ele vai cair, cedo ou tarde — a aplicação inteira quebra, porque ninguém escreveu o caminho de código que lida com um cache miss em massa e repentino.
“A invalidação de cache é tão difícil que nós criamos o ‘Time to Live’ (TTL) só para o tempo resolver o problema que a gente não soube resolver na arquitetura.”
Quando arquitetos e devs DEVEM cachear
“Dados que mudam pouco e são lidos muito” é o conselho que todo mundo já ouviu — e é verdadeiro, mas raso demais para decidir de verdade. Na prática, cachear não é uma escolha binária de sim ou não: é uma posição num espectro, definida por dois eixos independentes que precisam ser medidos, não estimados de cabeça.
A matriz que substitui o “achismo” por decisão
Cruze frequência de leitura com frequência de mudança e a decisão fica muito mais clara do que qualquer regra geral:
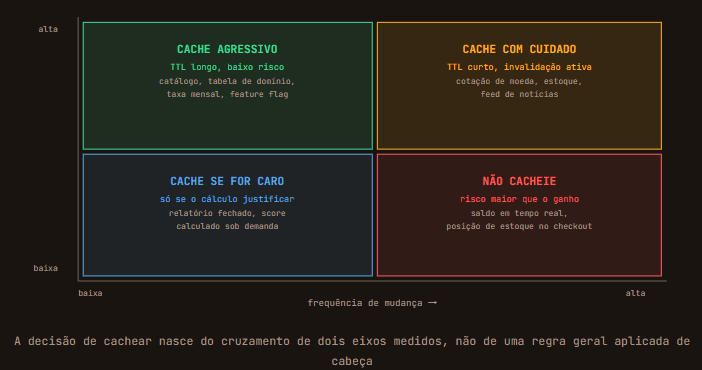
O eixo horizontal não deveria ser preenchido por intuição — é dado real de APM, de log de query, de métrica de acesso. “Eu acho que esse dado muda pouco” e “esse dado muda, em média, uma vez a cada 40 minutos, medido nos últimos 30 dias” são afirmações completamente diferentes, e só a segunda deveria autorizar uma decisão de cache em produção.
Cenário 1 — dados de alta leitura, baixíssima escrita
Exemplos concretos: a lista de países e estados de um formulário de cadastro, a tabela de tarifas de um banco atualizada uma vez por mês, a configuração de feature flags, as categorias de navegação de um e-commerce. É o cenário mais clássico e mais seguro para cachear — mas “seguro” não significa “sem perguntas”.
Pergunta do arquiteto
“Qual é a razão real entre leituras e escritas desse dado — 10 para 1? 10 mil para 1? Eu medi isso, ou estou assumindo que é alto porque parece óbvio?”
Pergunta do engenheiro
“Quem, além do meu próprio serviço, escreve nesse dado — um job em lote, um script de outro time, uma tela de administração separada? Esse caminho de escrita também invalida o cache, ou só o meu código lembra de fazer isso?”
Cenário 2 — cálculos computacionalmente caros que raramente mudam
Exemplos concretos: um score de crédito calculado a partir de múltiplas fontes de dados, um relatório de fechamento contábil do mês anterior, o resultado de um modelo de recomendação treinado uma vez por dia, um dashboard de métricas agregadas que varre milhões de linhas para gerar um único número.
Pergunta do engenheiro
“Esse cálculo é determinístico — o mesmo input sempre produz o mesmo output — ou depende de algum estado externo que pode mudar entre uma chamada e outra, tornando o resultado cacheado enganoso mesmo dentro do TTL?”
Pergunta do arquiteto
“Existe uma forma de recalcular esse valor de forma incremental, conforme os dados de origem mudam, em vez de recalcular do zero e depender de cache para esconder o custo? Às vezes o cache é usado para mascarar um algoritmo que deveria ser redesenhado, não otimizado com uma camada por cima.”
Cenário 3 — proteção de APIs de terceiros
Exemplos concretos: consulta de CEP e endereço, cotação de moeda de um provedor externo, verificação de score num bureau de crédito como Serasa ou SPC, geolocalização a partir de IP. Aqui o cache deixa de ser só otimização de performance e vira, também, controle de custo e de risco de bloqueio.
Pergunta do arquiteto
“Esse dado muda com a frequência que eu estou assumindo? A cotação do dólar muda a cada segundo no mercado, mas a minha aplicação realmente precisa dessa granularidade, ou um cache de sessenta segundos já é imperceptível para o caso de uso real?”
Pergunta do engenheiro
“Se o provedor externo cair e, ao mesmo tempo, meu cache expirar, existe um plano B — um valor default, uma resposta degradada — ou a minha aplicação simplesmente quebra em cascata porque dependeu de duas coisas saudáveis ao mesmo tempo?”
O estudo da feature: por que entender o negócio antes de cachear
Em termos simples
Decidir cachear um dado não é uma escolha puramente técnica — é uma escolha sobre o quanto de desatualização o negócio tolera, e essa resposta não mora no código, mora na cabeça de quem entende o produto.
A pergunta que todo engenheiro deveria fazer antes de configurar um TTL não é “quanto tempo esse dado pode ficar em cache?” — é “qual o impacto se o cliente vir esse dado desatualizado por X segundos?”. Se o saldo de uma conta bancária atrasar dois segundos por causa de cache, isso é inaceitável — dinheiro é o tipo de dado onde inconsistência tem consequência direta e mensurável. Se o estoque de um produto na Black Friday atrasar dois segundos, o prejuízo pode ser igualmente real: venda de item que já esgotou, cliente frustrado, estorno, reputação.
Essa pergunta não tem resposta técnica — tem resposta de produto. É por isso que decidir cachear, e por quanto tempo, exige uma conversa explícita com quem entende o impacto de negócio daquele dado específico, não uma decisão unilateral de engenharia tomada só olhando para o gráfico de latência.
Por que invalidar uma chave simples é fácil, e invalidar uma chave derivada não é
Vale um exemplo concreto do primeiro perigo da lista, porque a diferença entre os dois casos é onde a maioria dos bugs de cache realmente nasce:
invalidação simples — um dado, uma chave

// atualizar o perfil de um usuário
atualizarUsuario(usuario)
cache.invalidar(`usuario:${usuario.id}`)  // direto, óbvio, uma chave
invalidação derivada — um dado, dezenas de chaves possíveis
// atualizar UM produto, que aparece em várias listagens cacheadas
atualizarProduto(produto)
cache.invalidar(`produto:${produto.id}`) // fácil
cache.invalidar(`categoria:${produto.categoriaId}`) // esse produto está numa listagem por categoria...
cache.invalidar(`vitrine:destaques`) // ...que também aparece na vitrine...
cache.invalidar(`busca:*termo-relacionado*`) // ...e em resultados de busca. Esqueceu um? Bug sileA primeira invalidação é trivial. A segunda é onde “a coisa mais difícil da computação” ganha o apelido: cada novo lugar onde aquele dado aparece, de forma direta ou agregada, é mais uma chave que alguém precisa lembrar de invalidar — e esquecer uma única delas não gera erro nenhum, só um dado desatualizado silencioso em produção.
Estratégias clássicas de caching
Cache-Aside (Lazy Loading)
O código busca no cache primeiro; se não encontrar, busca no banco e popula o cache para a próxima vez. É a estratégia mais comum, mais simples de implementar, e a que dá mais controle explícito ao próprio código da aplicação.
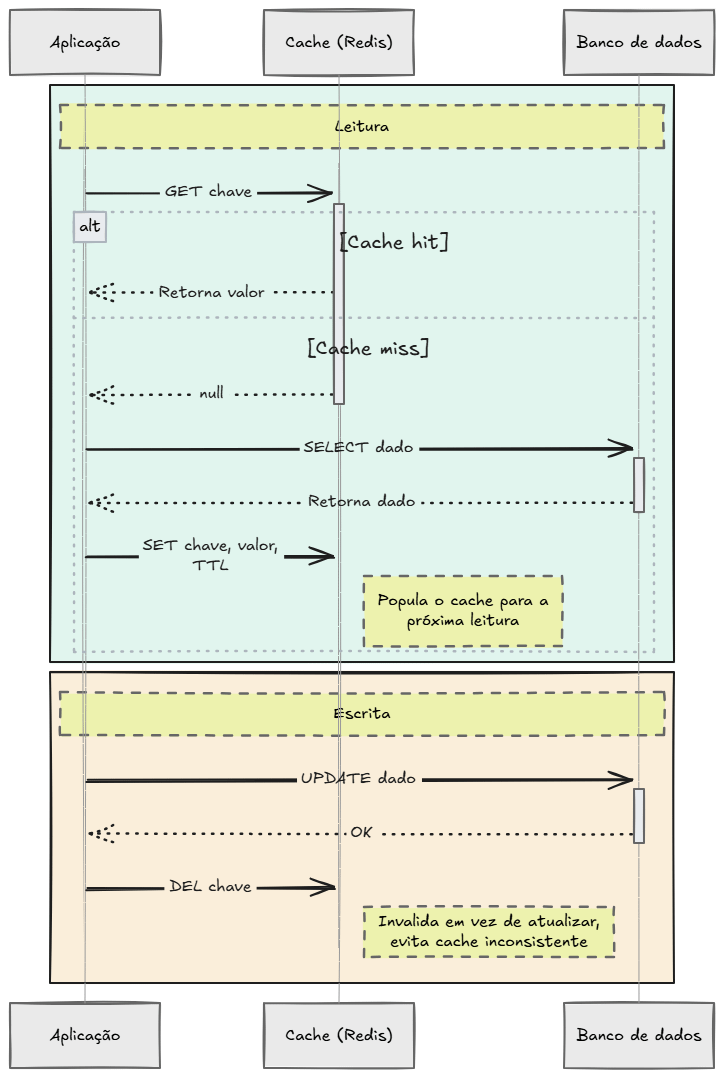
✓ Prós
Só entra em cache o dado que é efetivamente pedido — sem gastar memória com o que ninguém lê.
O cache pode cair inteiro sem quebrar a aplicação: pior caso, tudo vira miss e volta a bater no banco.
✗ Contras — atenção no debug
A primeira requisição depois de um miss é sempre mais lenta — se acontecer em massa (stampede), o pico atinge o banco de uma vez.
A responsabilidade de invalidar fica espalhada pelo código da aplicação — fácil esquecer um caminho de escrita, gerando stale data silencioso.
Pergunta antes de adotar
“Quantos lugares no código escrevem esse dado — e cada um deles sabe que precisa invalidar a mesma chave, ou só o caminho ‘principal’ lembra disso?”
Write-Through / Write-Behind
A escrita passa pelo cache antes de ir para o banco (Write-Through, síncrono e mais seguro) ou é enviada ao banco de forma assíncrona depois (Write-Behind, mais rápido para quem escreve, com uma janela de risco se o cache cair antes de persistir).
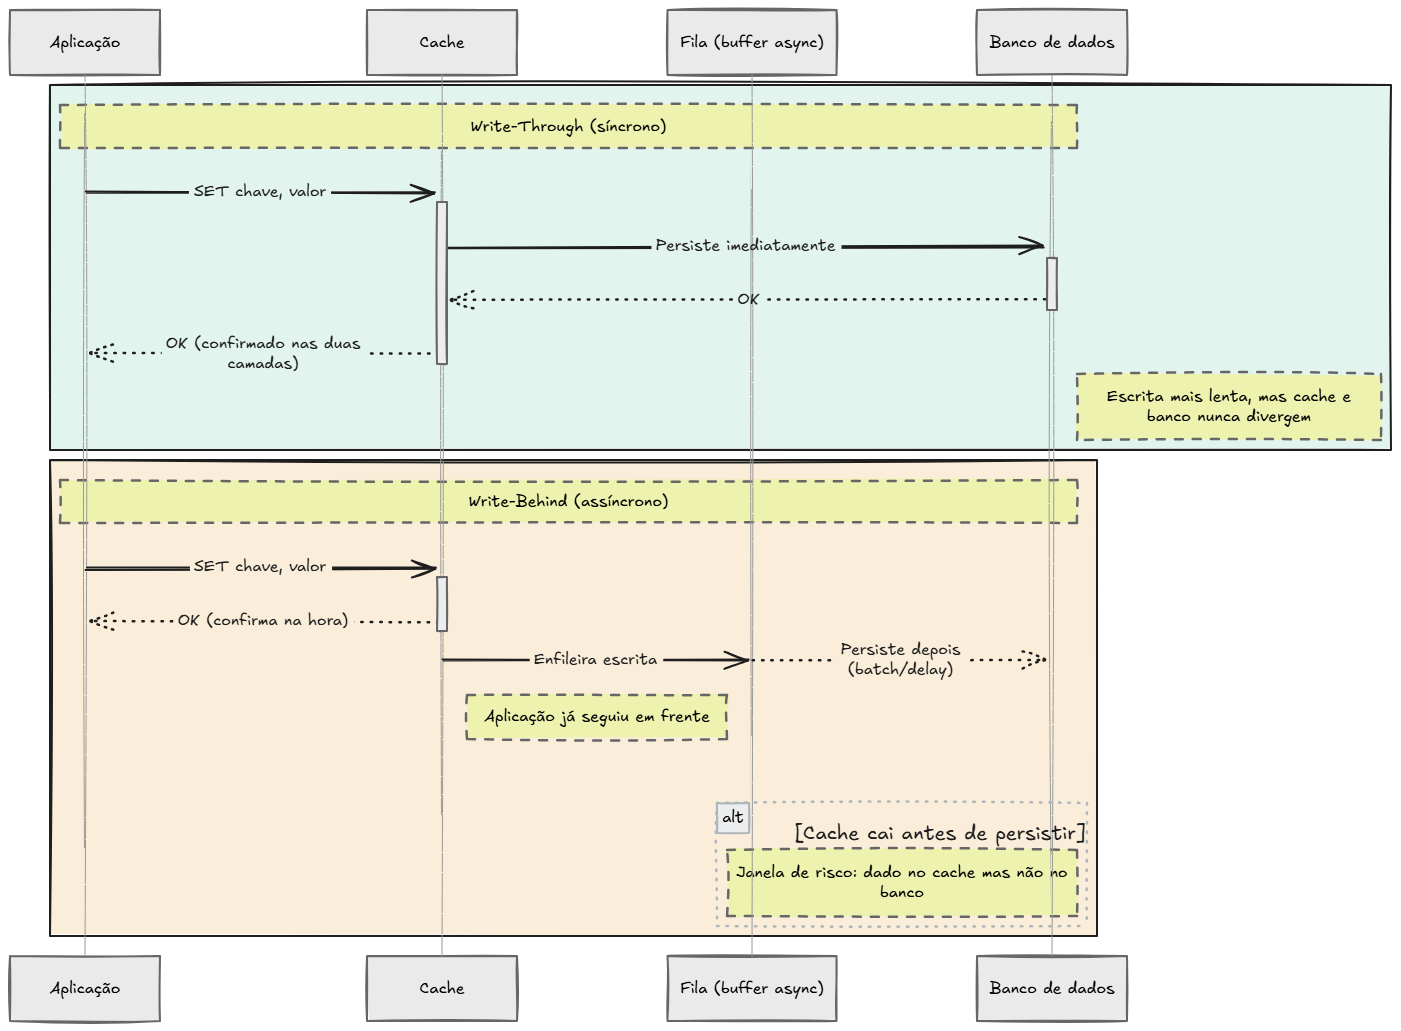
✓ Prós
Cache e banco tendem a ficar sincronizados por construção — muito menor chance de stale data comparado ao Cache-Aside.
Write-Behind reduz a latência percebida pelo cliente, já que a confirmação não espera o banco responder.
✗ Contras — atenção no debug
Write-Through adiciona latência a toda escrita, porque agora ela depende da saúde de dois sistemas em vez de um.
Write-Behind cria uma janela real de perda de dado: se o cache cair antes de persistir no banco, a escrita “confirmada” nunca chegou lá.
Pergunta antes de adotar
“Se eu escolher Write-Behind, e o cache cair no meio da janela assíncrona, que dado exatamente eu aceito perder — e alguém do negócio já concordou explicitamente com essa perda?”
Read-Through
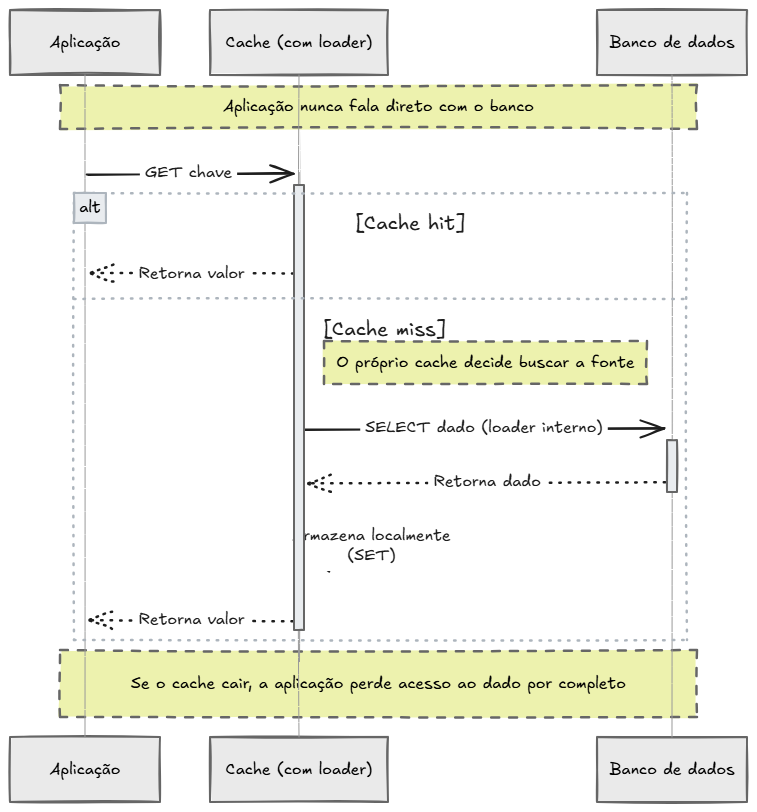
A aplicação só conversa com o cache — nunca diretamente com o banco — e é o próprio cache que se encarrega de buscar a fonte quando necessário. Centraliza a lógica de busca, mas cria mais dependência da camada de cache estar sempre saudável.
✓ Prós
A lógica de “buscar na fonte se não tiver em cache” fica centralizada numa única camada, em vez de duplicada em cada ponto do código que lê esse dado.
Simplifica bastante o código da aplicação, que passa a conhecer só uma interface — o cache — em vez de duas.
✗ Contras — atenção no debug
Cria uma dependência mais forte: se o cache cair, a aplicação não sabe mais falar diretamente com o banco, porque nunca foi desenhada para isso.
Debugar um dado errado é mais opaco — a lógica de busca mora dentro do provedor de cache, fora da visão direta do código da aplicação.
Pergunta antes de adotar
“Se a camada de cache ficar indisponível, minha aplicação tem algum caminho alternativo para falar com o banco — ou o Read-Through virou, sem perceber, um ponto único de falha disfarçado de otimização?”
O trade-off operacional: mais um componente na sua infra
Em termos simples
Todo componente novo que você adiciona à arquitetura é, também, mais uma coisa que pode quebrar às três da manhã — e alguém precisa saber operar, monitorar e pagar por ela.
Adicionar Redis ou Memcached à arquitetura não é uma decisão isolada de código — é adicionar mais uma instância para monitorar, mais um painel de métricas para manter, custo real de transferência de rede, gerenciamento de chaves em escala, e uma preocupação adicional de segurança sobre o que está sendo guardado em memória (e se precisa de criptografia). Nenhum desses custos aparece no código da feature; todos eles aparecem na operação, semanas ou meses depois.
✓ Vale a pena quando
O ganho de latência e a redução de carga no banco são mensuráveis e relevantes para o negócio — e existe capacidade real de operar mais um componente de infraestrutura com o mesmo cuidado que se dá ao banco principal.
✗ Não vale a pena quando
O problema real é uma query sem índice, um algoritmo ineficiente, ou um volume de tráfego que nem justifica a complexidade operacional extra — cachear, nesse caso, só adiciona um componente novo para quebrar sem resolver a causa raiz.
O que dizem os que já pagaram o preço do cache
Tudo o que foi dito até aqui é análise técnica — matriz de decisão, TTL, política de invalidação. Mas existe outra fonte de evidência que vale a pena ouvir: o que engenheiros com décadas de sistemas em produção, e mais de uma cicatriz de cache mal calibrado, escreveram sobre o assunto depois de já terem pago a conta. Três vozes, três ângulos diferentes do mesmo aviso.
“Existem apenas duas coisas difíceis em Ciência da Computação: invalidação de cache e dar nomes às coisas.” - Phil Karlton
A frase já tem mais de trinta anos e virou clichê de tanto ser repetida — o que, paradoxalmente, é a prova de que ela nunca deixou de ser verdadeira. Karlton não estava fazendo piada sobre dificuldade técnica; estava apontando que tanto nomear algo quanto invalidar um cache exigem a mesma coisa difícil: modelar corretamente uma realidade que muda com o tempo. Um nome errado e uma chave de cache não invalidada são o mesmo tipo de erro — a representação parou de corresponder à realidade, e ninguém percebeu no momento em que isso aconteceu.
“Cuidado ao colocar caches em muitos lugares!” - Sam Newman — Building Microservices
Newman escreve isso depois de descrever décadas de sistemas distribuídos que ele próprio ajudou a construir — e o aviso conecta direto com o que já conversamos nesse artigo: cache em camadas múltiplas (CDN, aplicação, banco) não soma proteção, multiplica a chance de alguma camada ficar com dado velho enquanto as outras já atualizaram. Ele também escreve, no mesmo livro, que entender o caminho completo do dado — da fonte até o destino final — é o que realmente revela a complexidade de um cache, não a implementação da chave em si. A lição prática é: antes de adicionar mais uma camada de cache, pergunte quantas já existem no caminho desse dado, porque provavelmente você não é a primeira pessoa a pensar nisso.
“...tão diferente do comportamento das variáveis em um programa normal de thread única.” - Martin Kleppmann — Designing Data-Intensive Applications
Kleppmann usa essa frase para descrever por que consistência eventual é difícil para desenvolvedores. A maioria dos bugs de cache nasce porque o engenheiro, mentalmente, ainda está raciocinando como se o sistema fosse uma única variável numa única thread — muda aqui, lê ali, sempre na ordem esperada. Um sistema com cache nunca é isso: é sempre múltiplas cópias do mesmo dado, em momentos diferentes de atualização, sendo lidas por múltiplos consumidores ao mesmo tempo. O bug não é a implementação; é o modelo mental que não corresponde à arquitetura real.
O fio que conecta os três: nenhum deles trata cache como uma decisão puramente local, resolvida no momento em que a chave é escrita. Os três tratam como uma decisão sistêmica, cujo preço é pago depois — não pelo engenheiro que configurou o TTL numa tarde tranquila, mas por quem estiver de plantão no dia em que a suposição de “isso está sempre atualizado o suficiente” deixar de ser verdade.
O checklist do engenheiro pragmático
Antes de configurar a primeira chave de cache, quatro perguntas honestas valem mais do que qualquer benchmark de performance:
O banco de dados já está otimizado — índices no lugar, queries revisadas — antes de adicionar uma camada de cache por cima do problema?
A métrica real de acesso (leitura vs. escrita) justifica o uso de cache para esse dado específico, ou é uma suposição não verificada?
O time definiu o TTL ideal para cada chave, com base no impacto de negócio de um dado desatualizado — não num número redondo escolhido de forma arbitrária?
A aplicação sobrevive se o cache cair agora mesmo — graceful degradation real, testada, não apenas assumida?
Cache não é uma pergunta de “como implementar”. É uma pergunta de “o que meu sistema, meu negócio e minha operação estão dispostos a pagar” — em latência tolerada, em complexidade operacional, e em confiança de que tudo continua de pé no dia em que o cache, inevitavelmente, cair.
Fundamentos de hierarquia de memória e cache em arquitetura de computadores (L1/L2/L3, décadas de 1960–70)
Padrões consolidados da indústria: Cache-Aside, Write-Through, Write-Behind, Read-Through
Cache Stampede / Thundering Herd — padrão de falha documentado em sistemas de alta escala
Phil Karlton — aforismo “two hard things in computer science” (via Martin Fowler’s bliki)
Sam Newman — Building Microservices: Designing Fine-Grained Systems
Martin Kleppmann — Designing Data-Intensive Applications