

No dia 4 de setembro de 2026, uma sexta-feira, o Pix liquidou 318.073.816 transações em 24 horas, movimentando R$ 186,89 bilhões. Foi o segundo recorde diário em nove meses — o anterior, de 313,3 milhões, tinha sido cravado em 5 de dezembro de 2025. As duas datas têm a mesma assinatura, e não é acaso: as duas são o último dia bancário antes do prazo legal de pagamento de salários. Em dezembro de 2025 esse prazo caiu exatamente na sexta, dia 5. Em setembro de 2026 caiu num sábado, e as empresas anteciparam para a sexta anterior. O pico não segue a data — segue o calendário bancário. Em 2026, a média nacional já ronda três mil transações por segundo, todos os dias, o dia inteiro.
Guarde duas coisas desse parágrafo. A primeira é a palavra média: ela é a mentira mais cara do capacity planning. A segunda é que o recorde não foi surpresa — ele estava no calendário. Volte a esse detalhe quando chegarmos à seção 04.
Aquele mesmo minuto de pico foi visto de três lugares diferentes. O usuário viu uma tela de confirmação em dois segundos e não pensou mais no assunto. O SRE de plantão viu um gráfico subindo e uma métrica de saturação chegando perto de um limiar. E o Banco Central viu um número que, no fim do mês, vira nota do participante — com peso, com histórico e com consequência.
Este artigo é sobre tudo o que existe entre essas três visões. E ele parte de duas assimetrias que quase nenhum material sobre Kubernetes menciona, porque quase nenhum material sobre Kubernetes foi escrito pensando em um arranjo de pagamentos regulado:
As duas assimetrias do Pix
1. O SLO não é escolhido pelo time de SRE — ele é herdado da norma. Em produto comum, o time negocia a meta de disponibilidade com o Product Owner. No Pix, a meta chega pronta, por categoria de participante, e o descumprimento tem consequência regulatória.
2. A capacidade não é escolhida pelo produto — ela é imposta pelo tráfego de entrada. Você decide quantos Pix seus clientes enviam. Você não decide quantos Pix eles recebem.
01 / FUNDAMENTOS
Vocabulário sem vergonha
Se você já opera EKS há cinco anos, leia esta seção mesmo assim — não pelas definições, mas pela terceira, sobre a palavra provisionar, que é onde a maioria das reuniões de arquitetura descarrilha.
Cluster
Pense num condomínio residencial. Ele tem duas metades que quase nunca se confundem: a administração e os prédios.
A administração guarda a planta do empreendimento, decide qual apartamento vago vai receber qual morador, mantém o cadastro de quem está onde e passa o dia conferindo se a realidade bate com a planta. Ela não mora em lugar nenhum e não carrega móvel. Ela decide. Os prédios, por sua vez, não decidem nada — eles têm parede, encanamento, elevador e capacidade finita. É neles que a vida acontece.
Um cluster Kubernetes é exatamente isso. O control plane é a administração: API server, etcd, scheduler e controller manager. Ele guarda o estado desejado — “quero 28 réplicas deste serviço” — e trabalha sem parar para que a realidade se pareça com esse desejo. O data plane são os prédios: os nós, que no seu caso são instâncias EC2, com CPU e memória finitas, rodando a carga de verdade.
No EKS, a AWS opera a administração do condomínio por você, com escritórios em bairros diferentes da cidade — múltiplas zonas de disponibilidade. Você não vê essa administração, não a ajusta e não a demite às três da manhã. O que é seu, o que você dimensiona e o que você eventualmente derruba são os prédios.
Por que essa divisão importa às 3h da manhã
Quando um pod não sobe, a pergunta certa quase nunca é “o control plane está com problema?”. A administração recebeu o pedido, anotou na planta e está tentando alocar. O que costuma faltar é prédio: não há nó com espaço, não há IP livre na subnet, ou o morador não consegue entrar (imagem errada, segredo ausente, configuração inválida).
Um pod em Pending é um problema de capacidade ou de agendamento. Um pod em CrashLoopBackOff é um problema da sua aplicação. Nenhum dos dois é da AWS. Essa separação economiza uma hora de investigação em quase todo incidente.
Nó, pod, container, réplica
A analogia que funciona bem em treinamento interno: o nó é o prédio, o pod é o apartamento (com seu próprio endereço de rede), o container é o morador, e a réplica é a quantidade de apartamentos idênticos que você alugou. Escalar horizontalmente é alugar mais apartamentos. Escalar verticalmente é derrubar a parede e fazer um apartamento maior — com o inquilino dentro.
Provisionar (a palavra que causa confusão)
O mercado usa “provisionar” para três coisas diferentes, e o mal-entendido custa horas de reunião:
Provisionar infraestrutura — criar capacidade física: subir nós, aumentar o node group, pedir instâncias à AWS. Leva minutos.
Provisionar alocação — reservar CPU e memória para um pod dentro de um nó que já existe. É o campo
resources.requests. É contabilidade do scheduler, não capacidade real. Leva milissegundos.Provisionar atendimento — decidir quantas réplicas do serviço existem. É o
replicasou o HPA. Leva segundos.
Quando alguém diz “o serviço está mal provisionado”, pergunte qual dos três. Na prática, a maioria dos incidentes de capacidade em banco é do tipo 1 chegando atrasado para atender o tipo 3 — e voltaremos a isso na seção 05.
EKS, ECS ou Fargate
Três opções, três conversas diferentes. A comparação honesta não é sobre qual é melhor, é sobre o que cada uma cobra de você:
EKS — Kubernetes gerenciado
Ganha em: ecossistema maduro (HPA, KEDA, Karpenter, service mesh), portabilidade e facilidade de contratar gente que já conhece.
Custa em: complexidade operacional real e a necessidade de um time de plataforma dedicado — não é algo que um time de produto opera nas horas vagas.
Onde os bancos usam: core transacional. Iniciação, liquidação, consumidores do SPI.
ECS sobre EC2 — orquestração nativa da AWS
Ganha em: simplicidade operacional e integração direta com IAM, ALB e CloudWatch, sem camadas de tradução.
Custa em: acoplamento ao provedor e menos primitivas de escalonamento avançado quando o cenário aperta.
Onde os bancos usam: serviços de apoio, backoffice e integrações internas.
Fargate — computação sem gestão de nó
Ganha em: zero gestão de instância e isolamento por task.
Custa em: prêmio por vCPU, tempo de partida de task maior e — o ponto que pega — ausência de DaemonSet.
Onde os bancos usam: jobs, cargas esporádicas e ambientes de teste.
Atenção regulatória
A ausência de DaemonSet no Fargate não é detalhe estético. Agentes de segurança, coletores de log e sondas de conformidade em banco costumam rodar como DaemonSet — um por nó. Migrar um serviço crítico para Fargate sem redesenhar essa camada significa perder evidência de auditoria. Já vi essa conversa acontecer tarde demais, com o serviço em produção.
02 / DIMENSIONAMENTO
Horizontal e vertical: qual custa mais, qual derruba o cluster
Todo mundo sabe a definição. Poucos times sabem a consequência.
Vertical (scale-up): o pod fica maior
Você aumenta CPU e memória da mesma instância do serviço. Três problemas:
Teto físico. Existe uma maior instância disponível, e depois dela não há mais para onde ir.
Custo superlinear e ocioso. Você paga o tamanho do pico durante os vales. Às três da manhã, quando o Pix cai para uma fração do volume, aquela instância gigante continua na fatura.
Reinício. Este é o ponto crítico. Aplicar um novo tamanho a um pod significa recriar o pod. O VPA em modo
Automata e recria pods para redimensioná-los. Em um serviço que participa da liquidação de pagamentos, isso é matar processos no meio de transações — e o resultado não é um erro 500, é uma inconsistência contábil.
Horizontal (scale-out): mais réplicas do mesmo pod
É a única forma de escala que também entrega tolerância a falha: se você tem 28 réplicas em três zonas, perder uma zona é perder um terço da capacidade, não o serviço. Por isso é a escolha padrão. Mas ela tem custos escondidos que ninguém coloca no slide:
Cada réplica é mais um pool de conexões contra o banco de dados.
Cada réplica é mais um heap de JVM — o overhead de memória por instância é duplicado, não dividido.
Cada réplica é mais um handshake mTLS a ser negociado com a infraestrutura do Banco Central.
Cada réplica é mais um endereço IP consumido da sua subnet.
E qual delas custa mais?
O título desta seção faz duas perguntas, e a primeira tem resposta mais curta do que parece: depende de qual custo você está olhando, e a maioria dos times olha só um.
Na fatura da nuvem, a vertical costuma custar mais, por dois motivos que se somam. Instâncias grandes raramente têm preço proporcional — o salto de uma família para a seguinte cobra prêmio por densidade. E, pior, você paga o tamanho do pico vinte e quatro horas por dia, inclusive nas seis horas em que o Pix roda a uma fração do volume. A escala horizontal devolve capacidade quando o tráfego cai; a vertical não devolve nada.
No custo total de propriedade, a conta às vezes se inverte. Vinte e oito réplicas significam vinte e oito pools de conexão, vinte e oito heaps de JVM com seu overhead fixo, vinte e oito conjuntos de conexões TLS e vinte e oito vezes o custo do sidecar de malha, se você usa um. Em serviços com overhead fixo alto por instância, chega um ponto em que espalhar sai mais caro do que adensar — e esse ponto aparece na conta de memória antes de aparecer na de CPU.
A regra útil: a vertical desperdiça capacidade, a horizontal desperdiça overhead. Você escolhe qual desperdício prefere pagar. Mas só uma das duas pode te deixar sem serviço às onze da manhã de uma sexta-feira — e é essa a pergunta que realmente importa.
E qual delas derruba o cluster?
A resposta contraintuitiva: a horizontal. E quase nunca por esgotar CPU. Ela derruba por efeito de segunda ordem — o autoscaler funcionou perfeitamente e quebrou outra coisa. As mortes reais, em ordem de frequência:
Cinco formas de o autoscaling derrubar sua plataforma
1. Exaustão de IP no VPC CNI. No EKS, cada pod consome um IP real da subnet. O HPA sobe de 28 para 200 réplicas, o bloco CIDR acaba, e os pods ficam presos em ContainerCreating. Não é só o seu serviço: nenhum pod novo sobe no cluster. Mitigação: planejamento de CIDR desde o dia zero, prefix delegation, subnets dedicadas por cluster.
2. Exaustão do pool de conexões. 28 réplicas × 20 conexões = 560. Escalou para 90 réplicas: 1.800 conexões contra um banco que aceita 800. O autoscaling derrubou o banco de dados, e o banco de dados derrubou tudo. Mitigação: pooler externo, ou pool por réplica dimensionado em função do máximo de réplicas, não do atual.
3. Limite de ENI e de pods por instância. Cada tipo de instância EC2 suporta um número finito de interfaces de rede e, portanto, de pods. Escalar réplicas sem conferir esse teto gera pods pendentes com nós aparentemente vazios.
4. Thundering herd de inicialização. Quarenta pods Java subindo simultaneamente, cada um fazendo warmup de JIT, carregando cache e abrindo conexões. O pico de CPU da partida é maior que o pico do tráfego que motivou a escala. O cluster entra em espiral: mais carga → mais escala → mais partidas → mais carga.
5. HPA sem maxReplicas sensato. Combinado com Cluster Autoscaler, isso escala até estourar a quota da conta AWS ou o orçamento do trimestre. O incidente não é técnico; é uma ligação da área financeira.
Veredito prático
Use a escala vertical uma vez, offline, com teste de carga, para descobrir o tamanho certo de um pod. Use a escala horizontal sempre, em produção, para responder a tráfego. O erro comum é o inverso: chutar o tamanho do pod e ajustar réplicas por sensação.
03 / TRÁFEGO
O que você escala e o que você não escala
Aqui está a diferença entre dimensionar um e-commerce e dimensionar um participante do Pix.
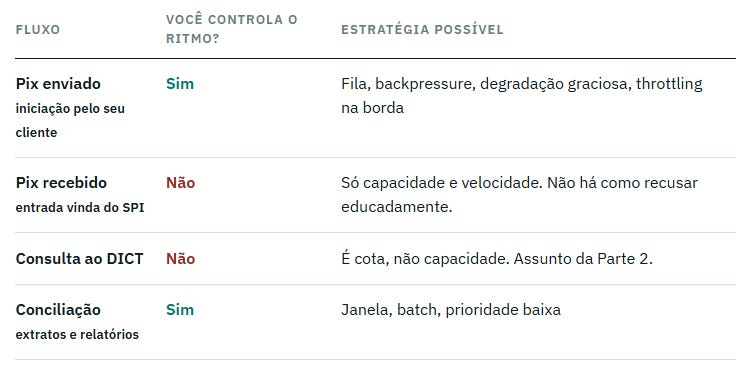
A frase para levar da seção: você pode enfileirar o que sai; não pode enfileirar o que entra. Se o Pix recebido não é processado dentro do tempo, isso não é uma fila crescendo — é um indicador regulatório sendo violado, com nome e CNPJ.
E há um detalhe de engenharia que muda completamente o modelo mental de quem vem do mundo web: a comunicação com o SPI não é push, é pull.
O Banco Central não bate na porta do seu servidor quando chega um Pix para o seu cliente. Em vez disso, o SPI mantém uma fila de saída por participante — uma caixa postal onde as mensagens destinadas a você se acumulam — e a responsabilidade de drenar essa caixa é inteiramente sua. Você inicia a leitura dessa fila com uma requisição GET, e a interface devolve no máximo dez mensagens por vez, em formato multipart. Se você parar de buscar, nada avisa ninguém: a caixa simplesmente enche, e o tempo continua correndo contra o seu indicador.
Além disso, a própria interface aplica controle de tráfego com saldo de tokens individualizado por participante — se o saldo zera, você recebe HTTP 429 com o cabeçalho Retry-After.
Consequência de arquitetura
Você não dimensiona um servidor HTTP esperando requisições do Bacen. Você dimensiona consumidores em laço: quantas threads fazem pull simultâneo, com que intervalo, com qual paralelismo de processamento por lote de dez mensagens, e como você desduplica e ordena o que chega. É um problema de consumidor de fila, não de API pública. A métrica de escala correta, portanto, não é CPU nem requisições por segundo — é profundidade de fila / lag de processamento.
04 / A CONTA
Do volume nacional ao número de réplicas
Até aqui: vocabulário e restrições. Daqui em diante, a conta.
Esta é a parte que quase nunca é escrita, e é a única que separa dimensionamento de adivinhação. Vamos usar um banco fictício com 5% de participação no volume nacional, num dia nacional de 300 milhões de transações — números redondos e inventados, escolhidos para você refazer a conta com os seus.
Aqui está a cadeia inteira, de uma vez. Os oito degraus que separam um número público do Banco Central de um valor no seu repositório de infraestrutura. As subseções seguintes justificam cada um deles.
DEGRAU                                     OPERAÇÃO              RESULTADO
──────────────────────────────────────────────────────────────────────────
1. Volume nacional do dia                                    300.000.000
2. Participação do banco                   × 5%               15.000.000 tx/dia
3. TPS médio do dia                        ÷ 86.400                  174 tps
4. Fator intradiário (vale da madrugada)   × 2,5                     434 tps
5. Fator de calendário (5º dia útil)       × 1,5                     651 tps
6. Fan-out interno (8 chamadas por Pix)    × 8                     5.208 rps
7. Capacidade medida por pod               ÷ 250 rps                20,8 pods
8. Margem operacional                      + 33%             28 RÉPLICAS
──────────────────────────────────────────────────────────────────────────
Nenhum desses números é meu. Todos são seus — e todos devem estar
versionados junto com a infraestrutura, com a data da última revisão.
Repare no que essa tabela permite. Quando o volume nacional crescer 20%, você não refaz o dimensionamento: você troca o degrau 1 e lê o resultado. Quando alguém adicionar uma chamada nova ao fluxo de pagamento, o degrau 6 vira 9 e o número de réplicas sobe sozinho. É isso que separa um dimensionamento de um chute com aparência de rigor.
Agora, degrau por degrau.
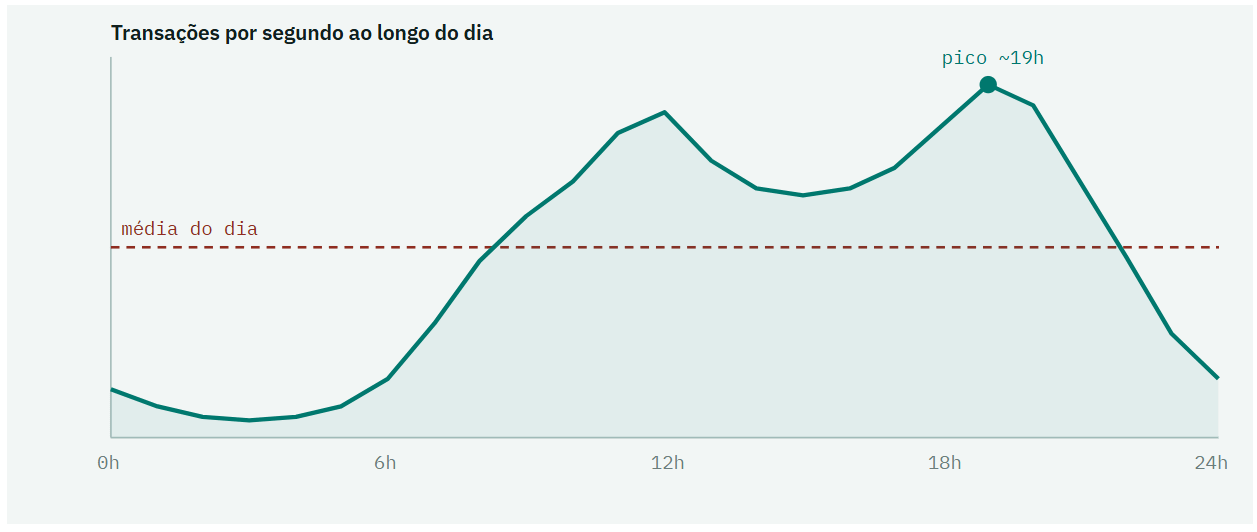
Degraus 4 e 5: os dois fatores de pico
Um erro comum é multiplicar tudo por um número mágico. São dois fatores distintos, medem coisas diferentes e se compõem:
Fator intradiário (degrau 4) — a razão entre o pico do dia e a média daquele mesmo dia. Existe por causa do vale da madrugada que você acabou de ver na curva. Tipicamente entre 2× e 3×; usei 2,5 na conta.
Fator de calendário (degrau 5) — a razão entre um dia excepcional e um dia comum. Janela de salário, dia 10, sexta-feira, véspera de feriado, Black Friday, dezembro com décimo terceiro. Tipicamente 1,5× a 2×; usei 1,5.
Volte agora aos dois recordes do primeiro parágrafo, porque eles ensinam a parte difícil do degrau 5. Em dezembro de 2025, o prazo legal de salário caiu na sexta, dia 5, e o pico foi no dia 5. Em setembro de 2026, o mesmo prazo caiu num sábado, as empresas anteciparam, e o pico foi na sexta, dia 4 — que não era o quinto dia útil por contagem nenhuma. Some ainda o feriado da Independência na segunda seguinte, e um contador ingênuo de dias úteis apontaria para o dia 8.
O erro que faz a pré-escala chegar quatro dias atrasada
Se o seu calendário de capacidade tem uma regra do tipo “escalar no quinto dia útil”, ele vai errar o dia em todo mês em que o prazo cair em sábado, domingo ou véspera de feriado. E vai errar para o lado pior: escalando depois do pico já ter passado.
A regra correta é o último dia bancário antes do prazo, o que exige lógica de fim de semana e de feriado bancário, não um contador. É uma função de dez linhas que ninguém escreve — e que vale mais, em disponibilidade, do que boa parte do YAML deste artigo.
A leitura maior é essa: isso não é volatilidade, é sazonalidade. E sazonalidade se coloca no calendário, não no relatório de incidente.
Degrau 6, o que todo mundo pula: fan-out
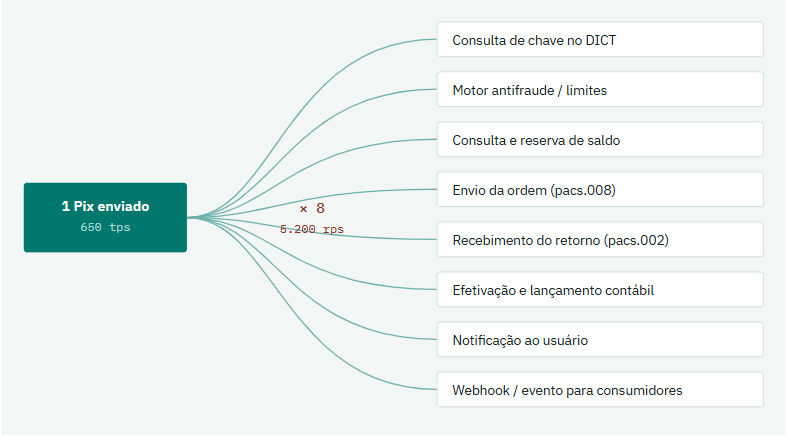
Um Pix não é uma requisição. É uma orquestração. Quando o time de produto diz “651 transações por segundo”, o time de plataforma precisa traduzir isso para o número real de chamadas que atravessam a malha interna. No fluxo de envio, cada transação costuma disparar algo próximo destas oito:
Consulta da chave no DICT
Motor antifraude e verificação de limites
Consulta e reserva de saldo
Envio da ordem de pagamento ao SPI (pacs.008)
Recebimento e processamento do retorno (pacs.002)
Efetivação e lançamento contábil
Notificação ao usuário
Publicação de evento para consumidores internos e webhooks
Daí o multiplicador 8 do degrau 6 — e daí os 5.208 requisições por segundo que o resto do dimensionamento usa. Oito é o número deste exemplo, não uma constante do mercado: o seu pode ser seis ou catorze, e a única forma de saber é medir. Cada uma dessas chamadas, além disso, precisa do seu próprio cálculo de capacidade, porque elas não têm a mesma latência nem o mesmo custo. E uma delas — a primeira — não pode ser dimensionada por este método de jeito nenhum, pelo motivo que a Parte 2 explica.
Lei de Little, em uma frase
concorrência = throughput × latência. Se você processa 5.200 requisições por segundo e cada uma leva 120 ms, existem cerca de 624 requisições vivas ao mesmo tempo dentro do seu sistema. É esse número — não o de requisições por segundo — que dimensiona threads, tamanho de pool de conexões e filas internas. E note a implicação perversa: se a latência dobrar por causa de uma dependência lenta, a concorrência dobra sem que o tráfego mude. É assim que uma lentidão externa vira esgotamento de thread pool interno.
Degrau 7: quanto um pod aguenta
Este é o único degrau que não se calcula — se mede. Você sobe um pod isolado, aplica carga crescente e encontra o ponto onde o percentil 99 começa a subir antes de a CPU saturar. No exemplo, esse ponto ficou em 250 requisições por segundo com p99 de 90 ms, num pod de 1 vCPU e 2 GB. Daí 5.208 ÷ 250 = 20,8 pods.
Se você pular esse teste e chutar a capacidade do pod, todos os sete degraus anteriores viram decoração. É o elo que transforma a cadeia em engenharia.
Degrau 8: a margem, e por que ela é 33% e não outra coisa
Vinte e um pods atendem o pico se nada der errado. Como algo sempre dá errado, a margem cobre três riscos distintos, e vale explicitar cada um em vez de esconder todos atrás de um número redondo:
Erro de estimativa. Os degraus 4, 5 e 6 são aproximações. Se o fan-out real for 9 em vez de 8, você precisa de 23 pods, não 21.
Tempo de reação. Como a seção 05 vai mostrar, o HPA leva segundos e o provisionamento de nó leva minutos. A margem é o que sustenta o serviço durante esse intervalo.
Falha parcial. Pods morrem, nós são reciclados, um rolling update está sempre acontecendo em algum lugar.
Somando: 21 × 1,33 ≈ 28 réplicas.
O que 28 réplicas NÃO cobrem — e isso precisa estar escrito
Lembra da frase da seção 02, de que com 28 réplicas em três zonas perder uma zona é perder um terço da capacidade? Faça a conta até o fim: com uma AZ fora, sobram cerca de 19 pods servindo, e você precisava de 21 só para o pico. 28 réplicas não sobrevivem à perda de uma zona no horário de pico sem degradar o percentil 99.
Para sobreviver de verdade, a conta é 21 × 3/2 = 32 réplicas — porque as duas zonas restantes precisam carregar sozinhas o que três carregavam. A diferença entre 28 e 32 é aproximadamente 15% de custo de computação daquele serviço.
Escolher 28 é legítimo. Escolher 32 é legítimo. O que não é legítimo é escolher sem saber que escolheu. Essa é uma decisão explícita de risco contra custo, e ela pertence a um documento de arquitetura com data e responsável — não a um campo de YAML que alguém preencheu de memória. Se a sua instituição está na categoria A de disponibilidade, o assunto da Parte 2, esse parágrafo vale uma reunião.
Pense comigo
Você sabe qual é o fan-out real do seu fluxo de pagamento? Não o desenhado no diagrama de arquitetura — o medido, com trace distribuído, em produção, no horário de pico.
Na maioria dos times em que perguntei, o número medido era entre 30% e 100% maior que o número desenhado. Retries, chamadas de enriquecimento esquecidas, uma consulta de saldo feita duas vezes por dois serviços diferentes. Cada ponto percentual disso é hardware na fatura e latência no percentil 99 que o regulador lê.
05 / EXECUÇÃO
Do número ao YAML
Agora os 28 pods viram configuração. Cada valor abaixo vem de uma conta, não de um exemplo copiado da documentação.
# Serviço de iniciação de Pix — dimensionado para 5.208 rps de pico
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pix-iniciacao
spec:
  replicas: 28                       # degrau 8: 20,8 pods + 33% de margem
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 0              # 24x7x365: nunca reduzir capacidade durante deploy
  template:
    spec:
      terminationGracePeriodSeconds: 60   # > transação mais longa do fluxo
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels: { app: pix-iniciacao }
      containers:
        - name: app
          resources:
            requests:
              cpu: "800m"            # medido: 250 rps por pod a 800m
              memory: "1536Mi"
            limits:
              memory: "1536Mi"       # sempre. OOMKill > nó instável
              # cpu: deliberadamente ausente — ver nota sobre CFS
          env:
            - name: JAVA_TOOL_OPTIONS
              value: "-XX:MaxRAMPercentage=70.0 -XX:+UseG1GC"
          startupProbe:              # cobre o warmup da JVM
            httpGet: { path: /health/startup, port: 8080 }
            periodSeconds: 5
            failureThreshold: 24     # até 120s para subir
          readinessProbe:            # NÃO consulta dependência externa
            httpGet: { path: /health/ready, port: 8080 }
            periodSeconds: 5
          lifecycle:
            preStop:
              exec:
                command: ["sh","-c","sleep 15"]   # drenar antes de morrer
Por que não há limite de CPU
O limite de CPU no Kubernetes é implementado como cota do CFS do kernel: o container é throttled quando estoura a cota da janela, mesmo que haja CPU sobrando no nó. Em um serviço sensível a latência, isso significa introduzir pausas artificiais exatamente no percentil que o Banco Central mede. A prática dominante em plataformas transacionais: defina requests de CPU para garantir escalonamento justo, e não defina limits de CPU — ou defina com folga grande. Memória é o oposto: sempre limite, porque memória não é compressível e um pod vazando derruba o nó inteiro.
E quando a política da plataforma obriga limits?
Em muitos bancos, o time de plataforma exige limits de CPU em todos os workloads, por controle de custo, por isolamento entre inquilinos do cluster ou por exigência de auditoria. É uma decisão defensável e provavelmente você não vai revertê-la com um argumento sobre CFS. O que fazer então:
Dimensione o limite com folga real — algo entre duas e três vezes o requests, não o mesmo valor. Limite igual ao request é o cenário de throttling garantido. Meça antes de discutir: a métrica container_cpu_cfs_throttled_seconds_total mostra exatamente quanto tempo o seu pod passou parado esperando cota, e um gráfico dela ao lado do p99 encerra a conversa mais rápido do que qualquer argumento teórico. E, se o throttling for real e a política inegociável, negocie uma exceção para o caminho crítico de liquidação em vez de para o cluster inteiro — exceção estreita e justificada costuma passar onde a ampla não passa.
A armadilha do readinessProbe
Se o seu readinessProbe verifica a saúde de uma dependência externa — o DICT, por exemplo — uma instabilidade momentânea do Banco Central marca todos os seus pods como não prontos ao mesmo tempo. O balanceador remove todo mundo. Você acabou de converter uma degradação parcial de terceiro em indisponibilidade total sua, por conta própria, e o indicador que vai para o regulador é o seu.
Readiness responde: “este processo consegue atender?”. Liveness responde: “este processo precisa ser reiniciado?”. Nenhum dos dois responde “minhas dependências estão bem?” — isso é trabalho de circuit breaker e de painel, não de sonda.
A métrica de escala certa
CPU é uma péssima métrica de HPA para serviço que passa a maior parte do tempo esperando I/O — que é exatamente o caso de qualquer serviço de pagamento. Um pod pode estar com 30% de CPU e saturado de threads bloqueadas. As duas opções que funcionam:
Métrica custom via Prometheus Adapter — requisições por segundo por pod, ou latência no percentil 95, para os serviços de entrada síncrona.
KEDA com lag de fila — para os consumidores do SPI e para qualquer coisa orientada a evento. Como vimos na seção 03, o modelo do SPI é pull; a profundidade da fila é o sinal honesto.
behavior:
  scaleUp:
    stabilizationWindowSeconds: 0    # subir imediatamente
    policies:
      - type: Percent
        value: 100                   # dobrar
        periodSeconds: 30
  scaleDown:
    stabilizationWindowSeconds: 600  # descer só após 10 min estáveis
    policies:
      - type: Percent
        value: 10
        periodSeconds: 60
A regra é assimétrica de propósito: subir rápido, descer devagar. O custo de uma réplica a mais por dez minutos é centavos. O custo de uma réplica a menos durante um pico é um indicador.
O gap de dois minutos
Este é o problema que separa quem leu a documentação de quem operou o cluster num quinto dia útil.
Os números, em sequência. O HPA avalia métricas a cada 15 segundos e, com a janela de estabilização zerada, decide escalar em algo entre 15 e 30 segundos. Ele cria os pods imediatamente — e é aí que o problema começa, porque criar um pod não é o mesmo que ter onde colocá-lo. Se não há nó com espaço, o pod fica em Pending. Provisionar um nó novo leva cerca de 40 a 60 segundos com Karpenter e tipicamente 2 a 3 minutos com o Cluster Autoscaler clássico, somando decisão, chamada à API da AWS, boot da instância, registro no cluster e download de imagem.
Ou seja: entre o tráfego subir e a capacidade nova existir de verdade, passam-se de um a três minutos. Nesse intervalo, os pods novos existem no etcd e não existem em lugar nenhum. O pico do Pix não espera três minutos.
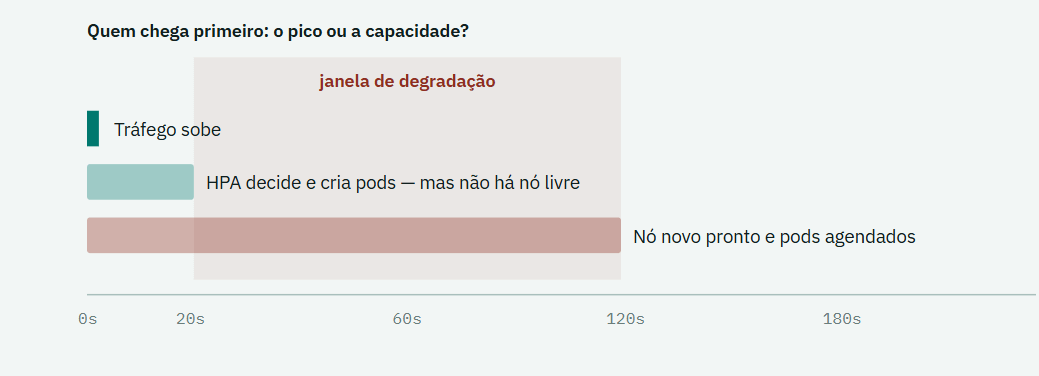
As três respostas usadas em produção para fechar esse intervalo:
Pods de headroom. Um Deployment de pods que não fazem nada, com
priorityClassde valor negativo, ocupando espaço em nós já provisionados. Quando o serviço real precisa escalar, o scheduler preempta os pods de headroom instantaneamente e usa a capacidade que já estava quente. Você paga capacidade ociosa em troca de tempo de reação — e em pagamento, tempo de reação é o produto.Pré-escala por calendário. Um CronJob que aumenta
minReplicasdo HPA antes das janelas conhecidas: último dia bancário antes do prazo de salário, dia 10, sextas, véspera de feriado, Black Friday, dezembro. Repare que a primeira dessas janelas é calculada, não é uma data fixa — como a seção 04 mostrou, uma regra ingênua de “quinto dia útil” erra o dia justamente nos meses em que o pico é maior. Sazonalidade previsível não deveria ser tratada como surpresa.Karpenter com node pools pré-aquecidos e diversidade de tipos de instância, para não depender de um único tipo estar disponível na AZ no momento exato do pico.
Prática de mercado
Os times de plataforma dos bancos brasileiros que operam Pix em volume relevante mantêm um calendário de capacidade versionado junto com a infraestrutura, e um freeze de mudanças nas janelas críticas. Não é burocracia: a maioria dos incidentes graves em ambiente transacional não é causada por excesso de tráfego, é causada por mudança feita perto do excesso de tráfego. O gráfico mostra capacidade; a causa raiz é o deploy.
Morrer direito
Um detalhe que só aparece quando o dinheiro é real. Quando o Kubernetes decide encerrar um pod, ele envia SIGTERM e, em paralelo, remove o pod dos endpoints do serviço. Essas duas coisas não são atômicas: existe uma janela em que o pod já recebeu o sinal de término e ainda está recebendo tráfego. Daí o preStop com uma pausa — ele dá tempo para a remoção propagar antes de a aplicação começar a se desligar. Depois disso, o terminationGracePeriodSeconds precisa ser maior que a transação mais longa em voo.
Sem isso, um rolling update rotineiro às 14h de uma sexta-feira interrompe liquidações no meio. E o efeito não é um erro que o usuário reenvia — é uma transação em estado indeterminado que alguém vai conciliar manualmente na segunda-feira.
06 / FECHAMENTO
O que a Parte 1 comprou
Se você seguiu a escada, agora existe uma cadeia auditável entre um número público do Banco Central e um valor no seu repositório de infraestrutura. Quando alguém perguntar “por que 28 réplicas?”, a resposta não é “foi o que a gente configurou”. São oito degraus, cada um com uma premissa nomeada, revisável quando o volume mudar — e ele vai mudar, todo trimestre. Dois recordes nacionais em nove meses deveriam bastar como aviso.
Um checklist do que revisar segunda de manhã:
Qual é o fan-out medido do seu fluxo de pagamento, não o desenhado?
Alguém já mediu quantos rps um pod seu aguenta, ou o degrau 7 é um chute?
A sua margem do degrau 8 cobre a perda de uma zona no pico — e, se não cobre, isso está escrito em algum lugar com data e responsável?
Seu
maxReplicasmultiplicado pelo tamanho do pool de conexões cabe no seu banco de dados?Seu bloco CIDR suporta o número máximo de pods que o HPA pode criar?
Seu
readinessProbedepende de terceiro?Existe headroom, ou o pico vai esperar o nó?
O
terminationGracePeriodSecondsé maior que a sua transação mais longa?
Pense comigo
Toda a matemática desta Parte 1 assume que capacidade é algo que você compra. Você calcula, provisiona, escala e o problema cede.
Na Parte 2 nós vamos encontrar o componente do ecossistema Pix onde essa premissa simplesmente não vale — onde adicionar réplicas não aumenta nada, porque o limite não é o seu hardware, é uma cota definida em norma. E onde a decisão entre um microserviço dedicado e uma função Lambda deixa de ser preferência arquitetural e vira uma conta de custo e de percentil.
Na Parte 2: como a API do DICT realmente funciona, o algoritmo de baldes e fichas do Banco Central, por que consulta de chave não escala como serviço normal, microserviço dedicado versus Lambda com a conta feita, a régua de disponibilidade por categoria de participante e o que muda no dia a dia dos times de engenharia e de SRE quando o SLO vem do regulador.
Fontes primárias para quem quiser conferir os números: Manual de Tempos do Pix, Manual Operacional do DICT e Manual das Interfaces de Comunicação, todos publicados pelo Banco Central; estatísticas do Pix no portal do BCB; repositórios
bacen/pix-apiebacen/pix-dict-apino GitHub. Os manuais são revisados com frequência — sempre confira a versão vigente antes de usar um número em decisão de arquitetura.
Obrigado por ler até o final, até o próximo!