

A maioria de nós sabe como colocar uma mensagem na fila. Se você trabalha com backend hoje, provavelmente já configurou um tópico no Kafka, subiu uma instância do RabbitMQ, provisionou uma fila no SQS ou configurou workers no BullMQ. Sabemos implementar a biblioteca, configurar a connection string e ver a mágica do desacoplamento acontecer.
Mas paramos por aí?
Saber a sintaxe de uma ferramenta é apenas a ponta do iceberg. O verdadeiro desafio não é fazer a mensagem chegar, mas entender o comportamento matemático de como essa fila cresce, esvazia ou colapsa sob pressão.
Por muito tempo, eu achei que garantir a entrega da mensagem era o suficiente. Até que enfrentei gargalos que não faziam sentido, latências que explodiam sem aviso e consumidores que travavam justamente quando o sistema estava ocioso. A ferramenta estava certa, o código estava limpo, mas a arquitetura estava falhando.
Foi nesse momento que precisei dar um passo atrás e estudar Teoria das Filas (Queueing Theory). Não a versão acadêmica e abstrata, mas a aplicação prática que define se o seu sistema distribuído vai sobreviver à Black Friday ou se vai se afogar em timeouts.
Neste artigo, vamos falar sobre a “matemática oculta” que rege o comportamento dos seus microsserviços e filas e que, surpreendentemente, poucos artigos abordam.
Teoria das Filas
A Teoria das Filas (Queueing Theory) não nasceu no Vale do Silício. Ela surgiu em Copenhague, em 1909, criada por um engenheiro e matemático chamado Agner Krarup Erlang. Ele trabalhava na companhia telefônica local e tinha um problema de negócios muito claro: quantas linhas telefônicas são necessárias para garantir que as pessoas consigam falar, sem que a empresa vá à falência instalando cabos inúteis?
Substitua “linhas telefônicas” por “tópicos no Kafka” ou “workers no Kubernetes”, e o problema de 1909 é exatamente o mesmo problema que você enfrenta hoje ao desenhar uma arquitetura distribuída.
Os Elementos Fundamentais
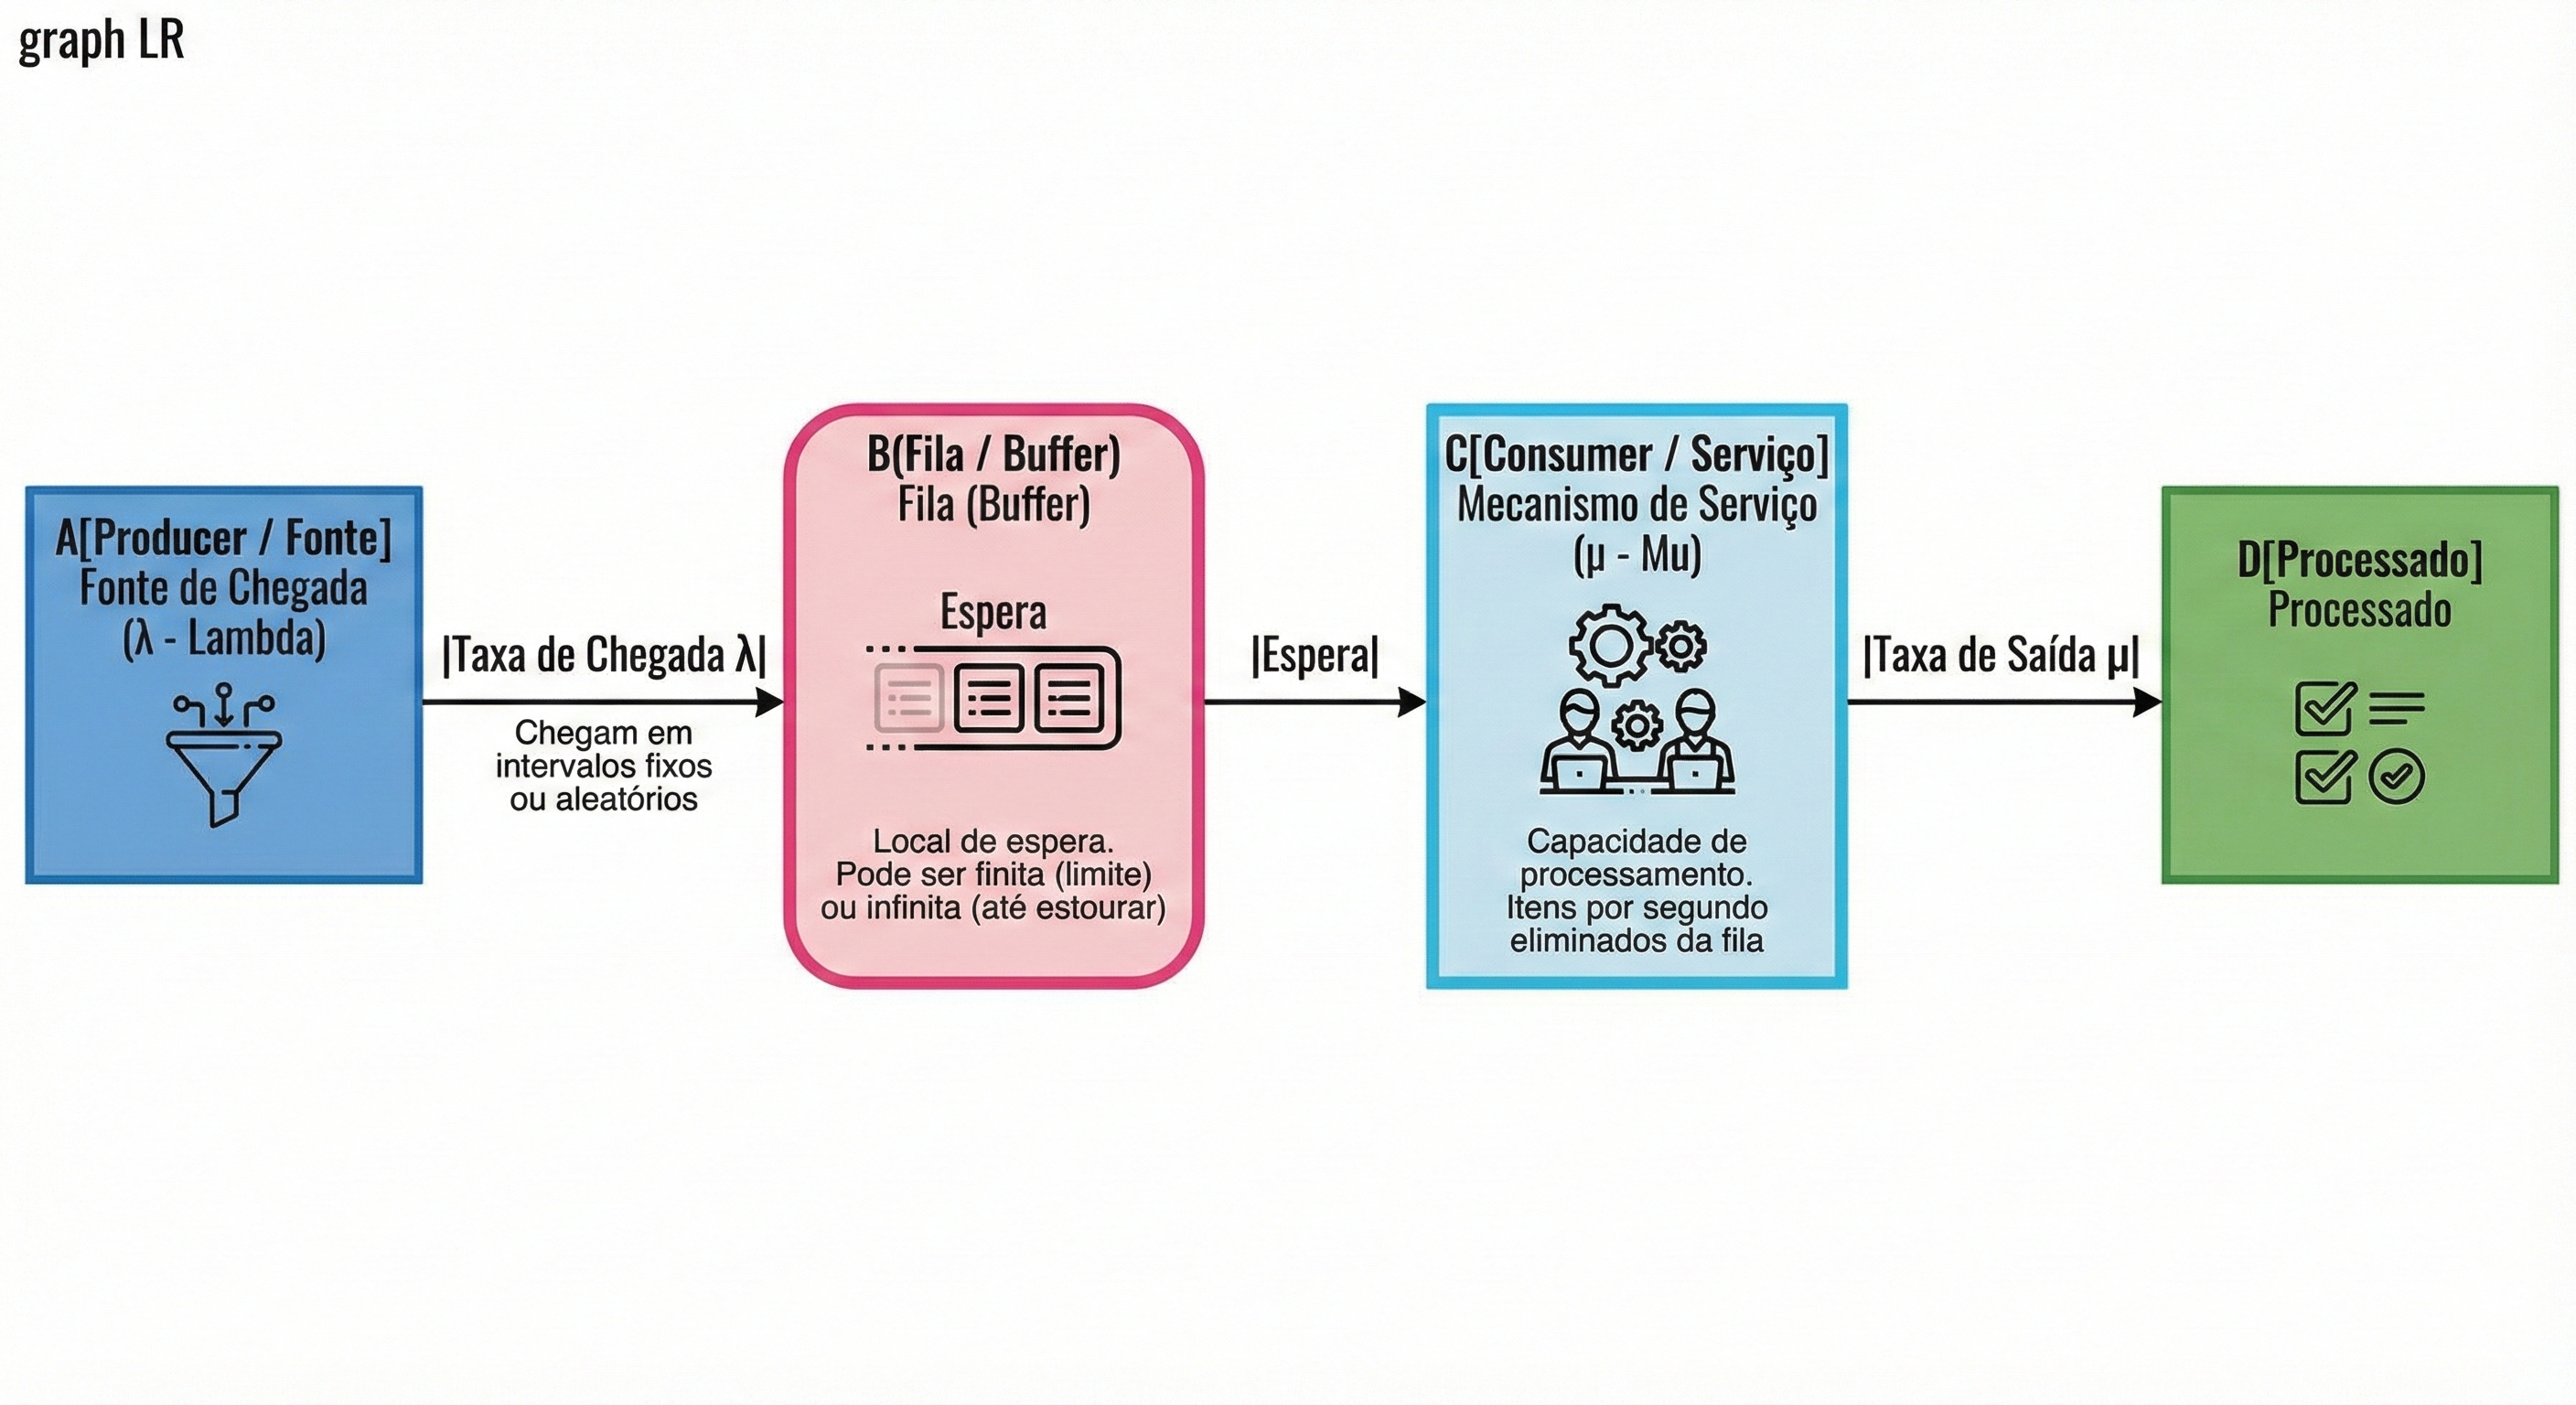
Para um engenheiro de software, qualquer sistema de fila — seja uma simples ArrayQueue em memória ou um cluster complexo de RabbitMQ — pode ser reduzido a três componentes matemáticos básicos (o modelo de Kendall):
A Fonte de Chegada (λ - Lambda): É a taxa na qual as requisições chegam ao sistema. No nosso mundo, são os Producers gerando eventos, cliques de usuários ou webhooks de terceiros. A característica mais importante aqui é a distribuição: elas chegam em intervalos fixos (previsível) ou aleatórios (estocástico)?
A Fila (Buffer): O local onde as requisições aguardam. Ela pode ser finita (tem um limite e depois disso rejeita dados) ou infinita (aceita dados até a memória do servidor estourar).
O Mecanismo de Serviço (µ - Mu): É a capacidade de processamento. São seus Consumers ou Workers. A taxa de serviço é quantos itens por segundo você consegue eliminar da fila.
Por que precisamos de filas? (A analogia do Amortecedor)
Se vivêssemos em um mundo perfeito onde o processamento de um dado (µ) fosse sempre mais rápido que a chegada dele (λ), filas seriam inúteis.
Precisamos de filas porque o mundo real é assíncrono e “rajado” (bursty).1
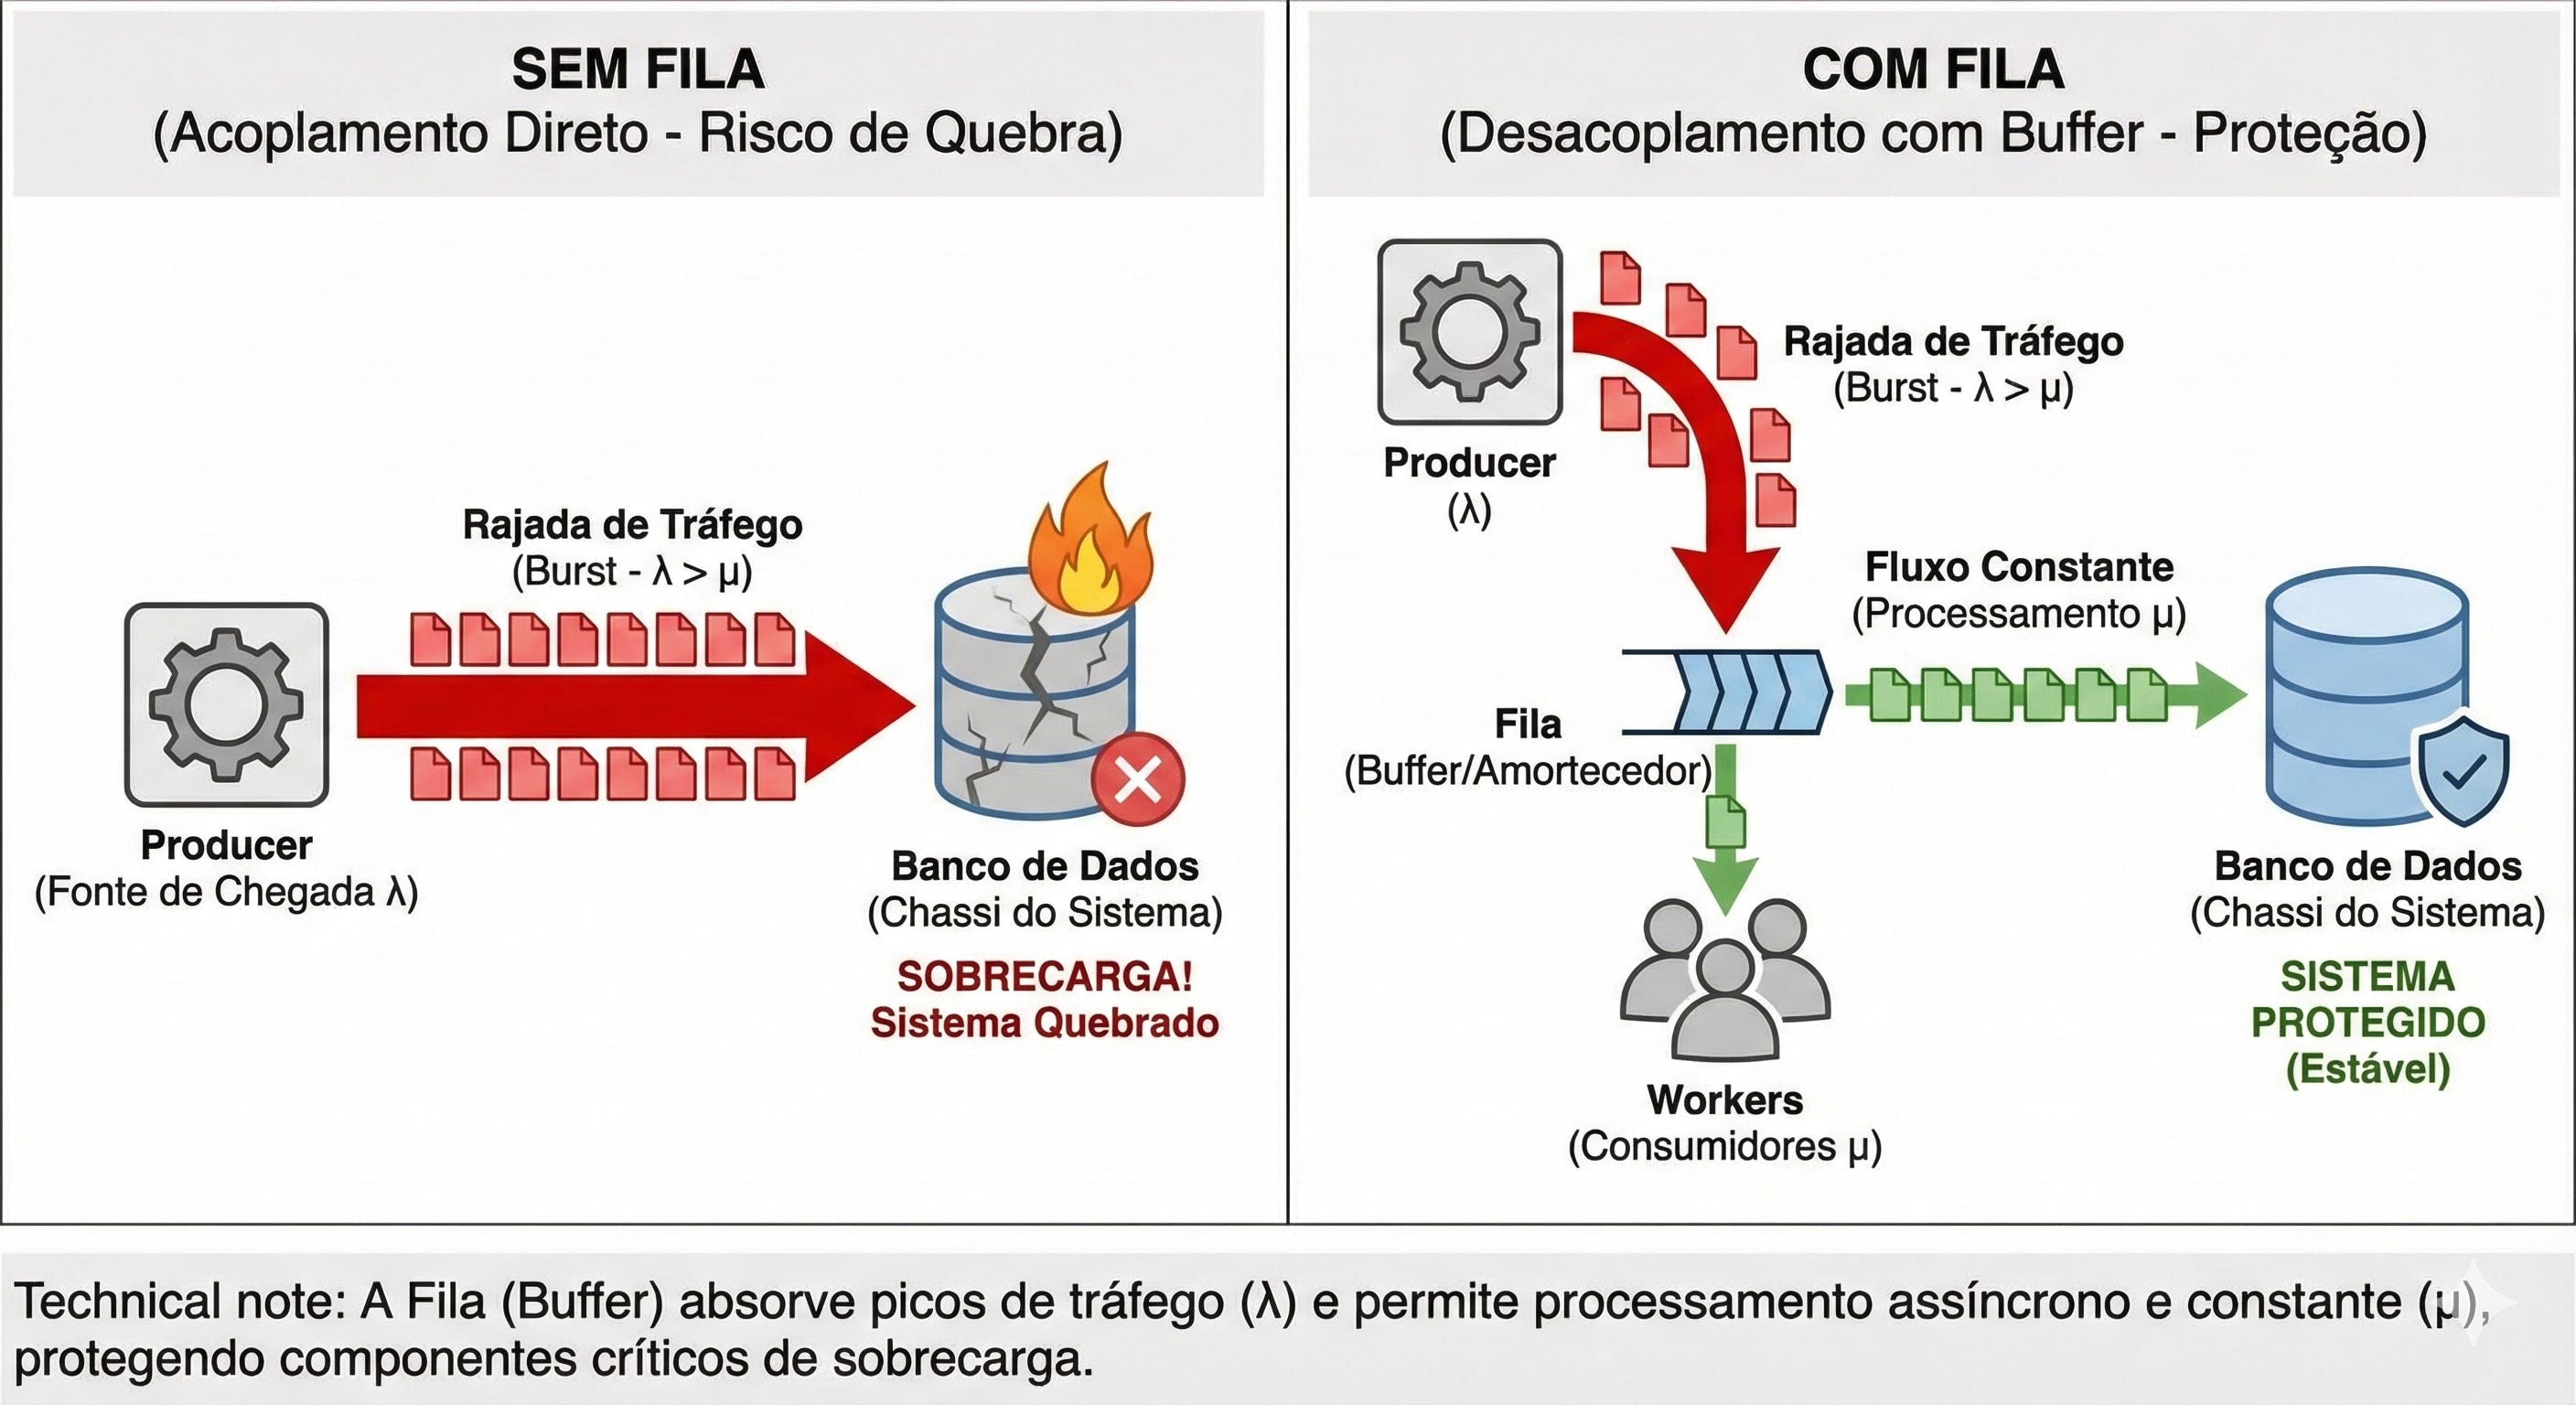
A fila atua como um amortecedor de choques. Imagine um carro passando por um buraco: a mola (fila) absorve o impacto imediato (pico de tráfego) e dissipa a energia lentamente ao longo do tempo (processamento pelos workers). Sem a fila, o impacto seria transferido diretamente para o chassi (banco de dados), quebrando o sistema.
Por que precisamos entender isso?
Aqui está o ponto cego da nossa profissão: nossa intuição linear falha em sistemas estocásticos.
A maioria dos programadores opera sob a lógica de que “se eu dobrar o número de servidores, eu corto a latência pela metade” ou “se meu servidor está em 80% de CPU, ainda tenho 20% de folga”.
Estudar Teoria das Filas nos ensina que essas afirmações são falsas. Sistemas de filas se comportam de maneira não-linear. Pequenas variações na taxa de chegada ou no tempo de serviço não causam pequenos aumentos na fila; elas podem causar colapsos catastróficos.
Entender o básico dessa teoria transforma você de um desenvolvedor que “aumenta a máquina quando o site cai” para um engenheiro que sabe matematicamente onde está o gargalo e, mais importante, consegue prever a falha antes que ela aconteça.
O “Joelho da Curva” e o Mito dos 100% de CPU
Se você já teve que justificar custos de infraestrutura para um gerente financeiro ou um CTO focado em cutting costs, já ouviu a frase:
“Nossos servidores estão rodando com apenas 40% de CPU. Estamos jogando dinheiro fora! Quero ver isso rodando perto de 100% para valer o que pagamos na AWS.”
Na cabeça de quem olha planilhas, 100% de utilização é eficiência máxima. Na matemática dos sistemas distribuídos, 100% de utilização é um estado de falha.
Para entender por que buscar a “utilização total” é suicídio arquitetural, precisamos primeiro definir o que estamos tentando proteger: a Latência.
O que é Latência?
Muitos devs confundem latência com “tempo de processamento”. Não são a mesma coisa.
Imagine que você vai a uma cafeteria. O barista leva exatos 30 segundos para fazer seu café.
Cenário A (Vazia): Você chega, pede, espera 30s. Sai com o café.
Tempo total: 30s.
Cenário B (Cheia): Existem 4 pessoas na sua frente. O barista ainda leva os mesmos 30s para fazer cada café.
Você espera 2 minutos na fila + 30s do seu café.
Tempo total: 2 minutos e 30s.
Latência é o Tempo Total.
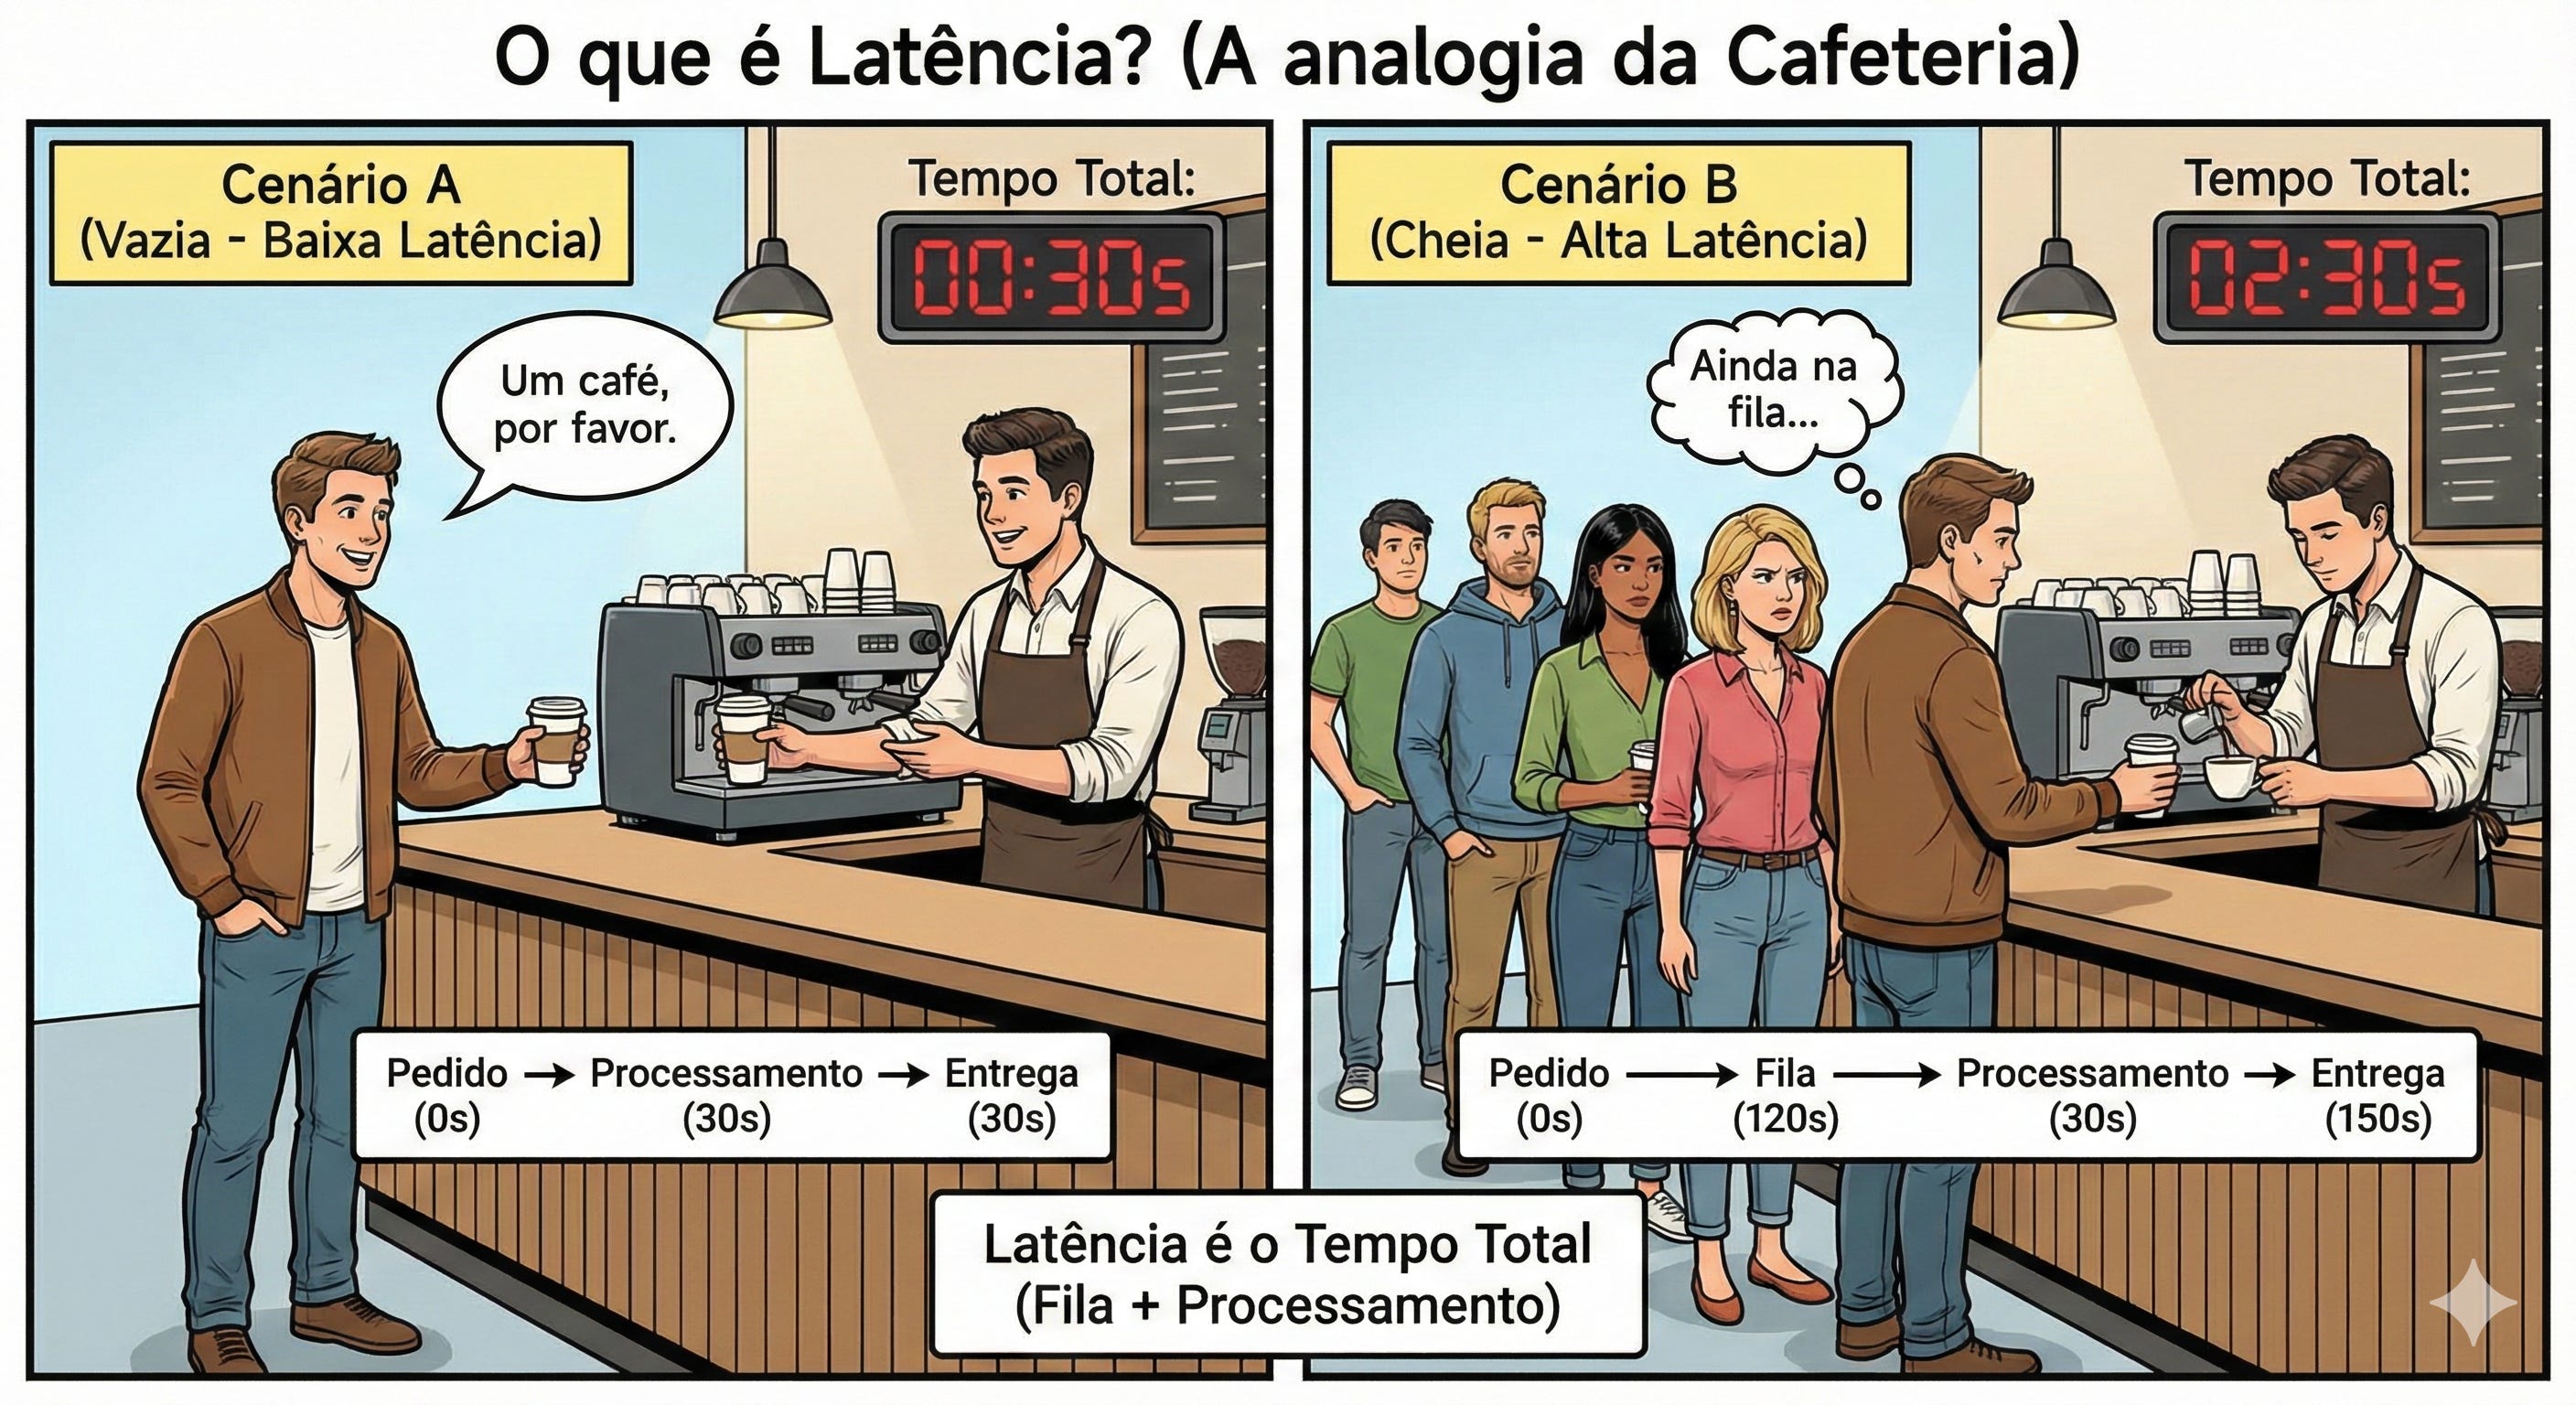
O tempo de serviço (fazer o café) costuma ser fixo. O que mata sua performance é o Tempo de Espera. E é aqui que entra a Fórmula de Kingman para explicar como a fila se comporta quando a loja enche.
A Fórmula de Kingman
A intuição humana é linear. Nós pensamos: “Se com 50% de ocupação a fila demora 1 minuto, com 100% de ocupação deve demorar 2 minutos”.
Errado.
A Fórmula de Kingman (uma aproximação para filas G/G/1) nos mostra que a relação entre ocupação e tempo de espera é exponencial.
Sem entrar no cálculo complexo, a parte da fórmula que importa para nós é o “Multiplicador de Utilização”:
Vamos rodar os números desse multiplicador para ver o estrago:
50% de Utilização:
Espera é “1x”. O sistema está saudável.
\((\rho = 0.5): \frac{0.5}{0.5} = 1 \)
80% de Utilização
A latência quadruplicou, embora a carga não tenha dobrado.
\((\rho = 0.8): \frac{0.8}{0.2} = 4\)
90% de Utilização
A latência ficou 9x maior
\((\rho = 0.9): \frac{0.9}{0.1} = 9\)
95% de Utilização
Latência 19x maior
\((\rho = 0.95): \frac{0.95}{0.05} = 19\)
Isso é insano! Para 99% isso salta para 99x mais latência, um verdadeiro pesadelo para a engenheria!
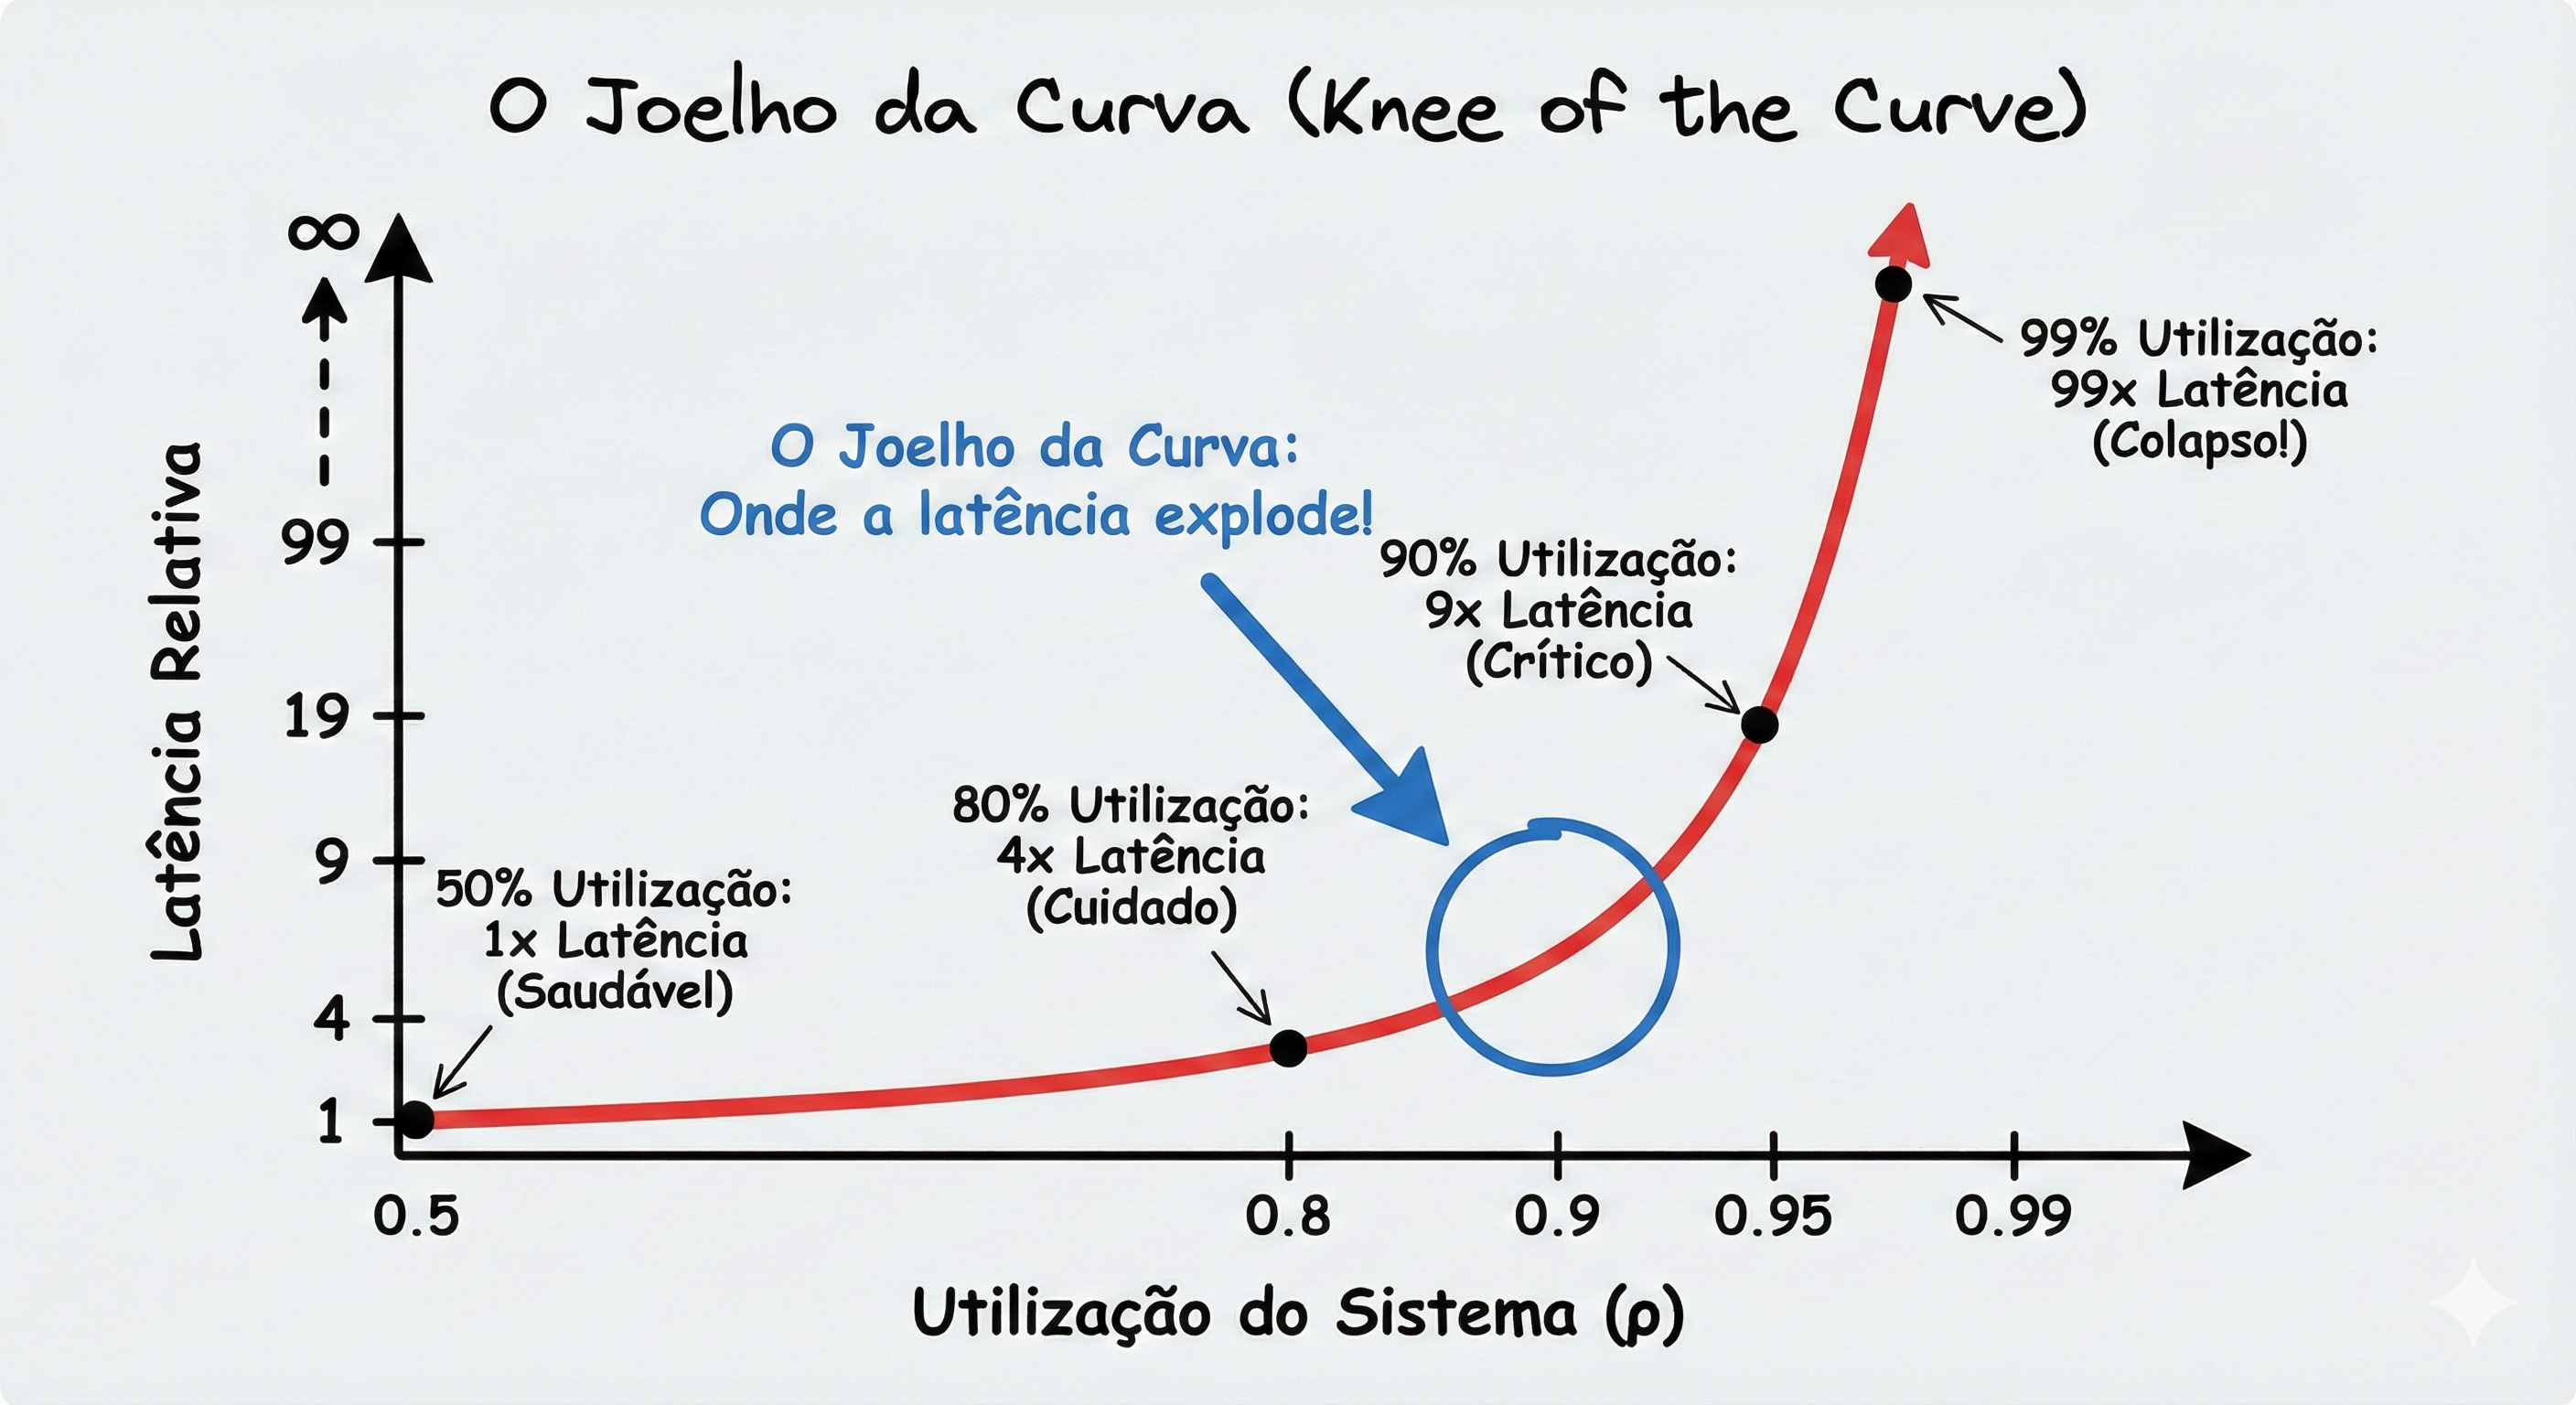
Esse ponto de inflexão (circulado em azul) é o “Joelho da Curva”.
É a mesma lógica do trânsito na estrada:
Com 50% de carros na pista, todos andam a 100km/h.
Com 70%, começa a ficar lento, mas anda.
Quando atinge 90% (saturação), um único carro freando causa um engarrafamento quilométrico e a velocidade cai para 0km/h.
O Suicídio dos 100%
Quando seu gerente pede “100% de CPU”, ele está matematicamente pedindo latência infinita.
Em um sistema de filas (Kafka, RabbitMQ), operar acima do “Joelho da Curva” (geralmente 70-80%) significa que você perdeu a capacidade de absorver a variabilidade (os bursts que falamos antes).
Se seus workers estão rodando a 90% de ocupação constante:
Qualquer micro-aumento de tráfego faz a fila crescer exponencialmente.
Qualquer soluço do sistema (um Garbage Collector do Java que para o mundo por 200ms) cria um backlog que o sistema nunca conseguirá recuperar, pois não há “gordura” (tempo ocioso) para processar o atraso.
A lição é a seguinte: Aqueles 20-30% de CPU ociosa que o financeiro quer cortar não são desperdício. Eles são o seu seguro contra latência exponencial. São o espaço necessário para que a fila possa esvaziar depois de uma rajada. Sem isso, seu sistema é uma bomba-relógio esperando o primeiro pico de tráfego para explodir.
O “Dia do Fechamento” e a Falácia dos 10%
Vamos sair da lousa e ir para a “War Room” de uma Fintech fictícia com 10 milhões de clientes.
Imagine esse cenário.
Todo dia 05 é o “Dia do Fechamento”. O sistema Core Banking dispara um gatilho que gera o fechamento de faturas. Isso não é um fluxo constante; é um canhão. Em uma janela de 4 horas, 10 milhões de eventos InvoiceClosed são publicados no Kafka.
A Arquitetura:
Producer: Core Legacy (Mainframe) empurrando dados.
Broker: Kafka (particionado corretamente).
Consumer: Um microsserviço de “Fidelidade” que escuta esse tópico, calcula pontos e atualiza o saldo do usuário no SQL Database.
Capacidade (Service Rate - μ): Seus workers aguentam processar 800 mensagens/segundo de forma estável.
O Histórico (Meses Anteriores):
A taxa de chegada (λ) durante o pico do dia 05 costuma oscilar em torno de 600 msg/s.
Vamos aplicar a fórmula de utilização:
Segundo Kingman, em 75%, estamos antes do “joelho”. O sistema fica um pouco lento, a fila sobe um pouco, mas drena rápido. O time de infra comemora: “O sistema é robusto!”.
O Elemento Caótico: A “Pequena” Mudança
Neste mês, o time de Produtos lançou uma feature nova: “Cashback Turbinado”.
Agora, para cada fatura fechada, o consumer precisa fazer uma validação extra em uma API externa de parceiros para ver se o cliente tem direito a bônus.
Os desenvolvedores mediram em Staging: essa chamada adiciona apenas 30ms ao processamento.
“É só 30ms a mais, e o Kafka aguenta tudo, certo? Vamos subir.”
O que ninguém calculou foi que esses 30ms reduziram a capacidade de processamento dos workers (μ) de 800 msg/s para 640 msg/s.
O Desastre Matemático
Chega o dia 05. O canhão dispara. A entrada (λ) continua sendo 600 msg/s. Mas a capacidade (μ) caiu para 640 msg/s.
Nova Utilização:
Na cabeça do gerente: “Ainda estamos abaixo de 100%, vai funcionar.”
Na matemática de Kingman, veja o multiplicador de espera:
Mês passado (75%):
Latência gerenciável.
\(\frac{0.75}{0.25} = 3x\)
Este mês (93.7%):
A latência mais que quadruplicou!
\(\frac{0.93}{0.07} \approx 13.2x\)
O Efeito Cascata
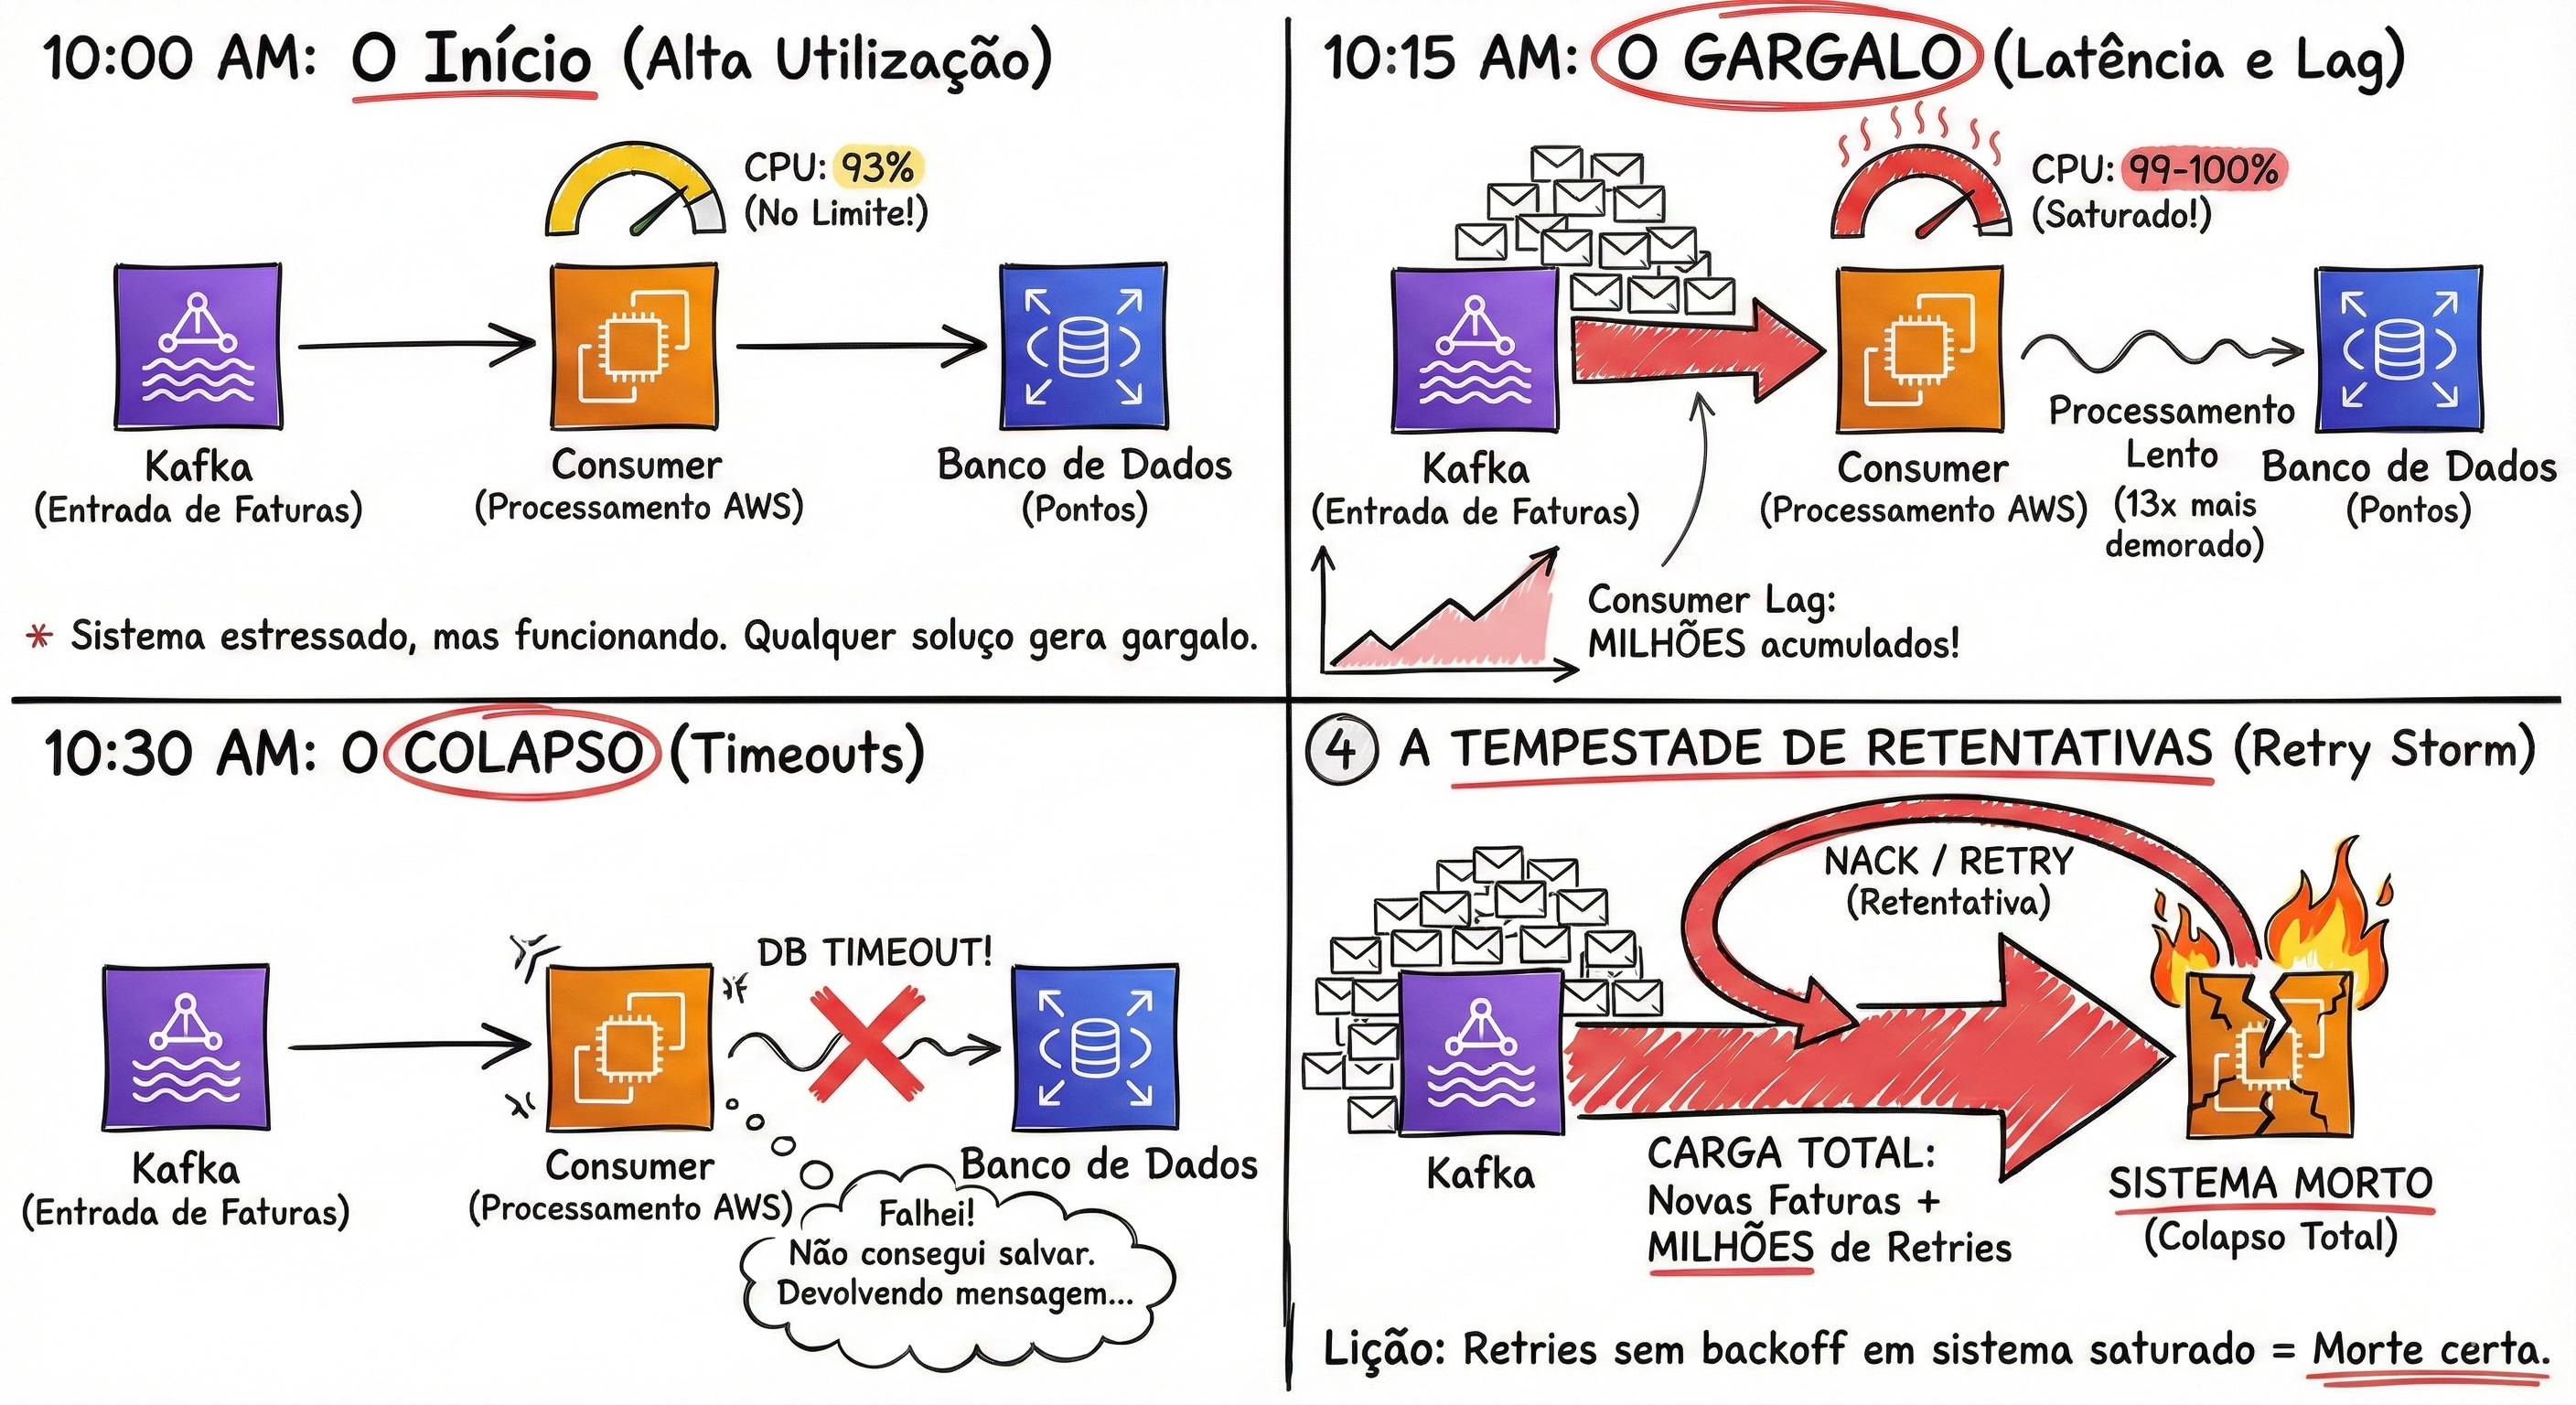
10:00 AM: O processamento começa. Como a utilização está em 93%, qualquer micro-variação (rede, GC do Java) empurra a utilização para 99% ou 100% momentaneamente.
10:15 AM: A fila do Kafka (Consumer Lag) começa a acumular. Não são mais mil mensagens, são milhões acumuladas.
10:30 AM (O Colapso): Como o processamento está demorando 13x mais, ocorreram timeouts de banco de dados no Consumer.
A Tempestade de Retentativas (Retry Storm): Aqui o sistema morre.
O consumer falha ao processar a mensagem devido ao timeout. O que ele faz? Devolve a mensagem para a fila (Nack/Retry).
Agora, sua taxa de chegada não é apenas as novas faturas. É a soma de:
- \(\lambda_{novas} + \lambda_{retries}\)
Sua utilização efetiva passa de 100%.
Resultado: O Kafka continua aceitando mensagens (ele “aguenta tudo”), mas seus consumers estão travados. O atraso na atualização de pontos passa de “alguns segundos” para “5 horas”. O suporte começa a receber chamados de clientes que pagaram a fatura mas não viram os pontos cair.
O que a matematica nos ensina?
A matemática previu esse desastre. A mudança parecia pequena (apenas 10-15% de perda de performance), mas como o sistema já operava perto do “Joelho da Curva” (75%), esse empurrão foi suficiente para jogá-lo na zona vertical da exponencial (93%), onde a latência tende ao infinito e o backlog se torna irrecuperável.
Se o time conhecesse Teoria das Filas, eles saberiam que não se adiciona complexidade a um sistema que já roda a 75% de carga sem antes escalar a infraestrutura (aumentar μ) para trazer a utilização de volta para baixo do joelho.
A Lei de Little: A Calculadora de Capacidade que Você Ignora
Agora que sabemos que operar perto de 100% é suicídio (graças ao Kingman), surge a pergunta inevitável: “Ok, então quantos servidores ou consumers eu preciso exatamente para não deixar meu sistema explodir?”
É aqui que a maioria dos arquitetos recorre ao “chutômetro”: “Ah, coloca uns 10 pods no Kubernetes e vê no que dá.”
Pare. Existe uma fórmula para isso.
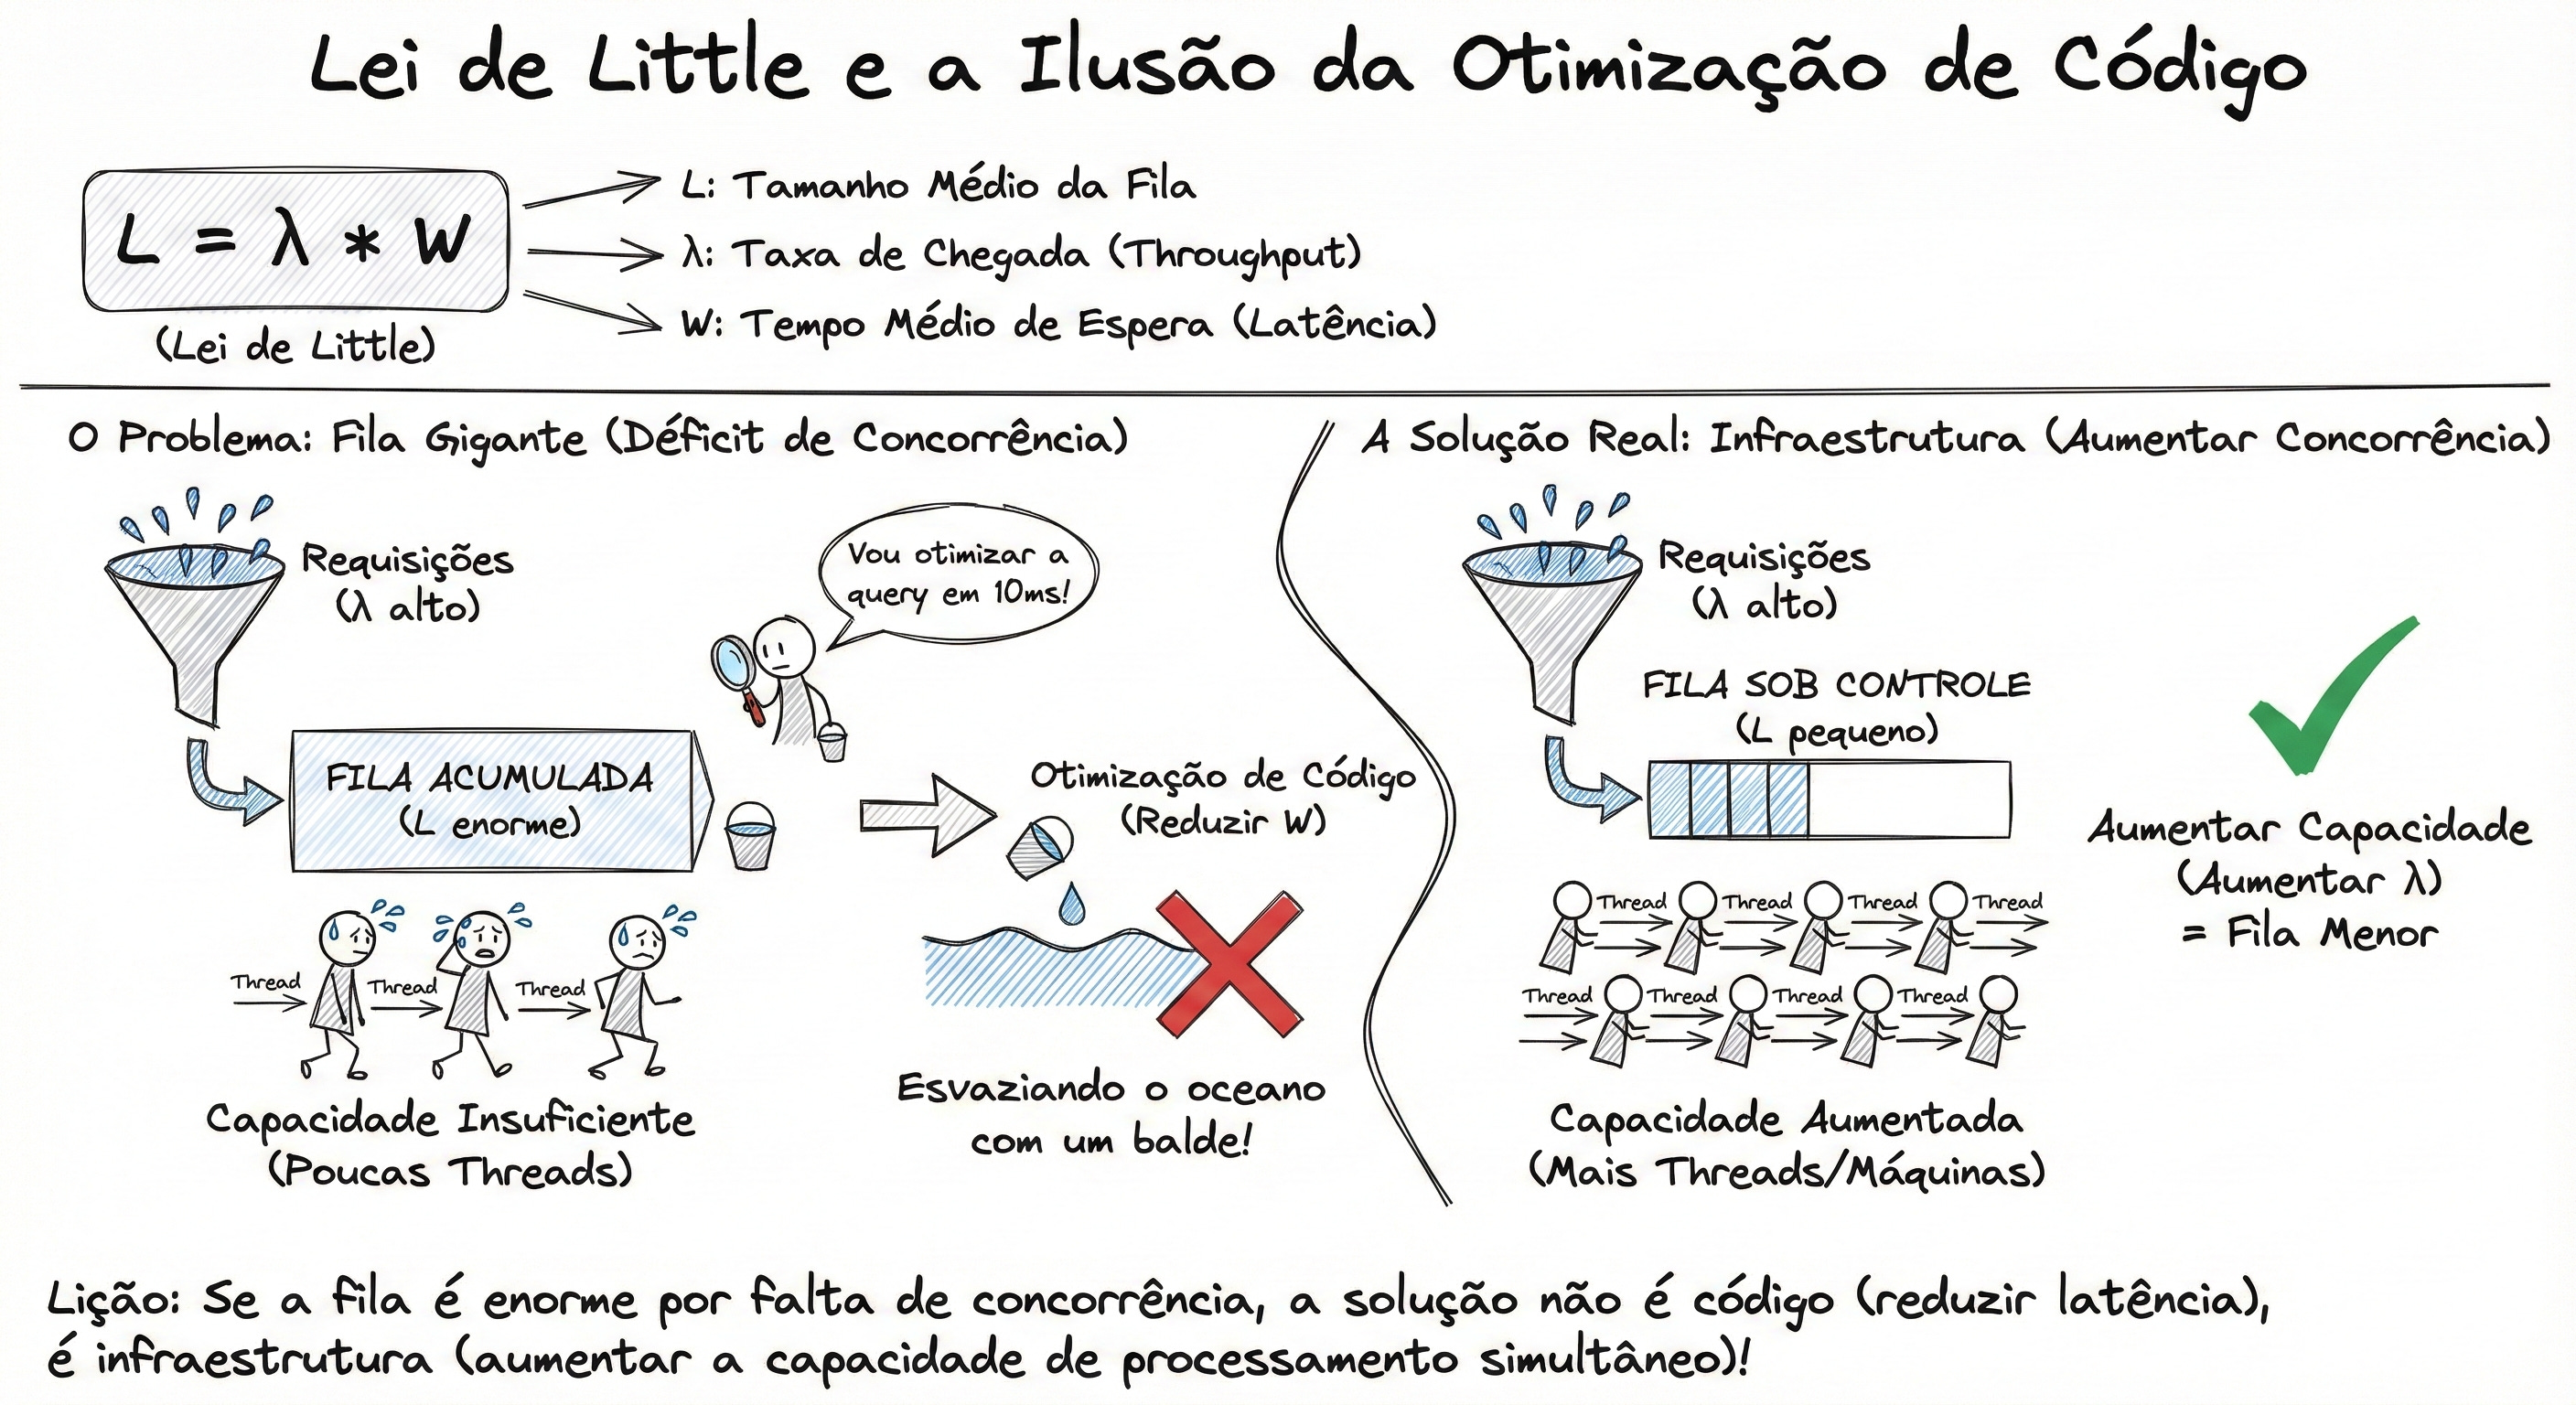
Ela se chama Lei de Little (Little’s Law) e é surpreendentemente simples, mas brutalmente honesta.
A Fórmula Mágica
Onde:
L (Length): O número médio de itens dentro do sistema (Processando + Fila). Em termos de software: Concorrência Necessária.
Lambda: A taxa de chegada (Requests por segundo).
W (Wait): O tempo médio que uma requisição leva para ser processada (Latência).
Parece abstrato? Vamos trazer para a sua realidade.
Um Exercício de Raciocínio
Imagine que você tem um worker consumindo mensagens do RabbitMQ.
Vamos aos fatos do seu sistema:
Fato 1: Seu sistema recebe 100 requisições por segundo constantes.
Fato 2: Seu código é razoavelmente otimizado e leva 200 milissegundos (0.2s) para processar cada mensagem (fazer o parse, salvar no banco e dar ack).
A pergunta é: Quantas threads ou conexões simultâneas você precisa para manter o sistema estável (sem a fila crescer)?
Não chute. Calcule.
Resposta: Você precisa, matematicamente, de capacidade para processar 20 mensagens simultaneamente o tempo todo.
Por que isso muda o jogo?
Agora, vamos aplicar a realidade da engenharia de software nesse número “20”.
Cenário A: O Programador Otimista
Você configurou seu consumer para rodar com 10 threads (ou 10 pods single-threaded), porque “10 parece um número bom”.
O que acontece? A Lei de Little exige 20. Você tem 10.
A cada segundo, 100 chegam, mas você só consegue dar vazão a 50 (10 threads / 0.2s).
Saldo: 50 mensagens acumulam na fila por segundo. Em um minuto, você tem 3.000 mensagens de lag. Em uma hora, 180.000. O Out of Memory (OOM) é inevitável.
Cenário B: O Programador que Entende a Lei
Você sabe que o número mágico é 20. Mas você se lembra do “Joelho da Curva” (não queremos rodar a 100%). Então, você aplica uma margem de segurança de 30%.
Você provisiona 26 a 30 threads.
Resultado: O sistema roda suave, a fila fica zerada e, se houver um pequeno pico, você tem gordura para queimar.
A Dura Verdade sobre “Otimizar Código”
A Lei de Little nos ensina uma lição de humildade sobre performance.
Muitas vezes, tentamos resolver problemas de fila acumulada mexendo no código.
“Vou otimizar essa query para ganhar 10ms!”
Se o seu déficit de concorrência for grande (ex: você tem 10 threads mas precisa de 50), ganhar 10ms no tempo de processamento é como tentar esvaziar o oceano com um balde.
Às vezes, a solução não é código (reduzir a latencia). A solução é infraestrutura (aumentar a capacidade para atingir a concorrência necessária).
Então o que podemos aprender?
Devemos considerar a Lei de Little quando desenhamos uma arquitetura? Absolutamente.
Ela transforma o Capacity Planning de uma arte obscura de adivinhação em uma ciência exata. Antes de subir qualquer sistema para produção, faça a conta:
Se a sua infraestrutura não suportar o resultado dessa multiplicação, seu sistema já nasceu morto.
Bufferbloat: Por que sua DLQ não vai te salvar
Se perguntarmos para qualquer desenvolvedor como ele lida com falhas em sistemas de mensageria, a resposta padrão é: “Temos uma Dead Letter Queue (DLQ) configurada. Se der erro, reprocessamos.”
Isso é ótimo para erros de sintaxe ou falhas lógicas. Mas a DLQ é inútil contra o maior inimigo da performance em alta escala: o Bufferbloat.
Enquanto a DLQ cuida das mensagens que “morreram” (deram exceção), o Bufferbloat cria um exército de “Mensagens Zumbis”: requisições que estão tecnicamente vivas na fila, consumindo recursos, mas que já não servem para mais nada.
O Problema das Filas Infinitas (Unbounded Queues)
A maioria das bibliotecas de clientes (seja em Java, Node ou Python) e configurações padrão de brokers (como RabbitMQ clássico) tendem a tratar filas como infinitas. A premissa ingênua é: “Se o consumidor está lento, guarde tudo na memória. Não rejeite nada. Eventualmente processaremos.”
O artigo clássico “Preventing Unbounded Buffers with RabbitMQ” nos alerta sobre a física básica desse problema: Producers quase sempre são mais rápidos que Consumers. Se você tem um producer injetando 1.000 req/s e um consumer drenando 900 req/s, essa diferença não desaparece. Ela se acumula na RAM.
Vamos aplicar a lógica matemática para ver onde isso quebra.
A Matemática do “Trabalho Zumbi”
Imagine o cenário de um pico de tráfego (burst):
Sua fila acumulou 5.000 mensagens.
Seu worker leva 100ms para processar cada uma (persistência, regras de negócio).
Cálculo de Latência na Cauda:
- \(5.000 \text{ msgs} \times 0.1s = 500 \text{ segundos}\)
Isso significa que a última mensagem da fila vai esperar mais de 8 minutos para ser atendida.
Agora, olhe para o contrato com seu cliente (SLA ou Timeout):
O aplicativo móvel do usuário tem um timeout de 10 segundos.
O gateway de pagamento espera resposta em 30 segundos.
A paciência humana dura 1 minuto.
O Resultado Lógico:
Quando seu servidor pegar a mensagem nº 5.000 (daqui a 8 minutos), o cliente já recebeu um TimeOut Exception, já fechou o app ou já clicou em “Tentar Novamente” (criando duplicidade).
Mas o servidor não sabe disso. Ele vai gastar CPU, memória e I/O de banco de dados para processar uma requisição cujo “dono” já foi embora.
Isso é desperdício puro. Em engenharia de performance, chamamos isso de queda de Goodput (vazão útil). Seu servidor está trabalhando a 100% de carga, mas entregando 0% de valor.
Por que isso acontece em sistemas Assíncronos?
Aqui reside a confusão comum: “Mas se é assíncrono, por que o tempo importa?”
O assincronismo desacopla a conexão (o código não trava), mas não elimina a expectativa temporal.
A informação tem prazo de validade.
Se o e-mail de “Redefinir Senha” demora 10 minutos por causa da fila, o usuário já solicitou outro token, invalidando o anterior.
Filas infinitas transformam problemas de capacidade (falta de hardware) em problemas de latência (demora infinita), o que é muito pior para o negócio.
Backpressure e Load Shedding
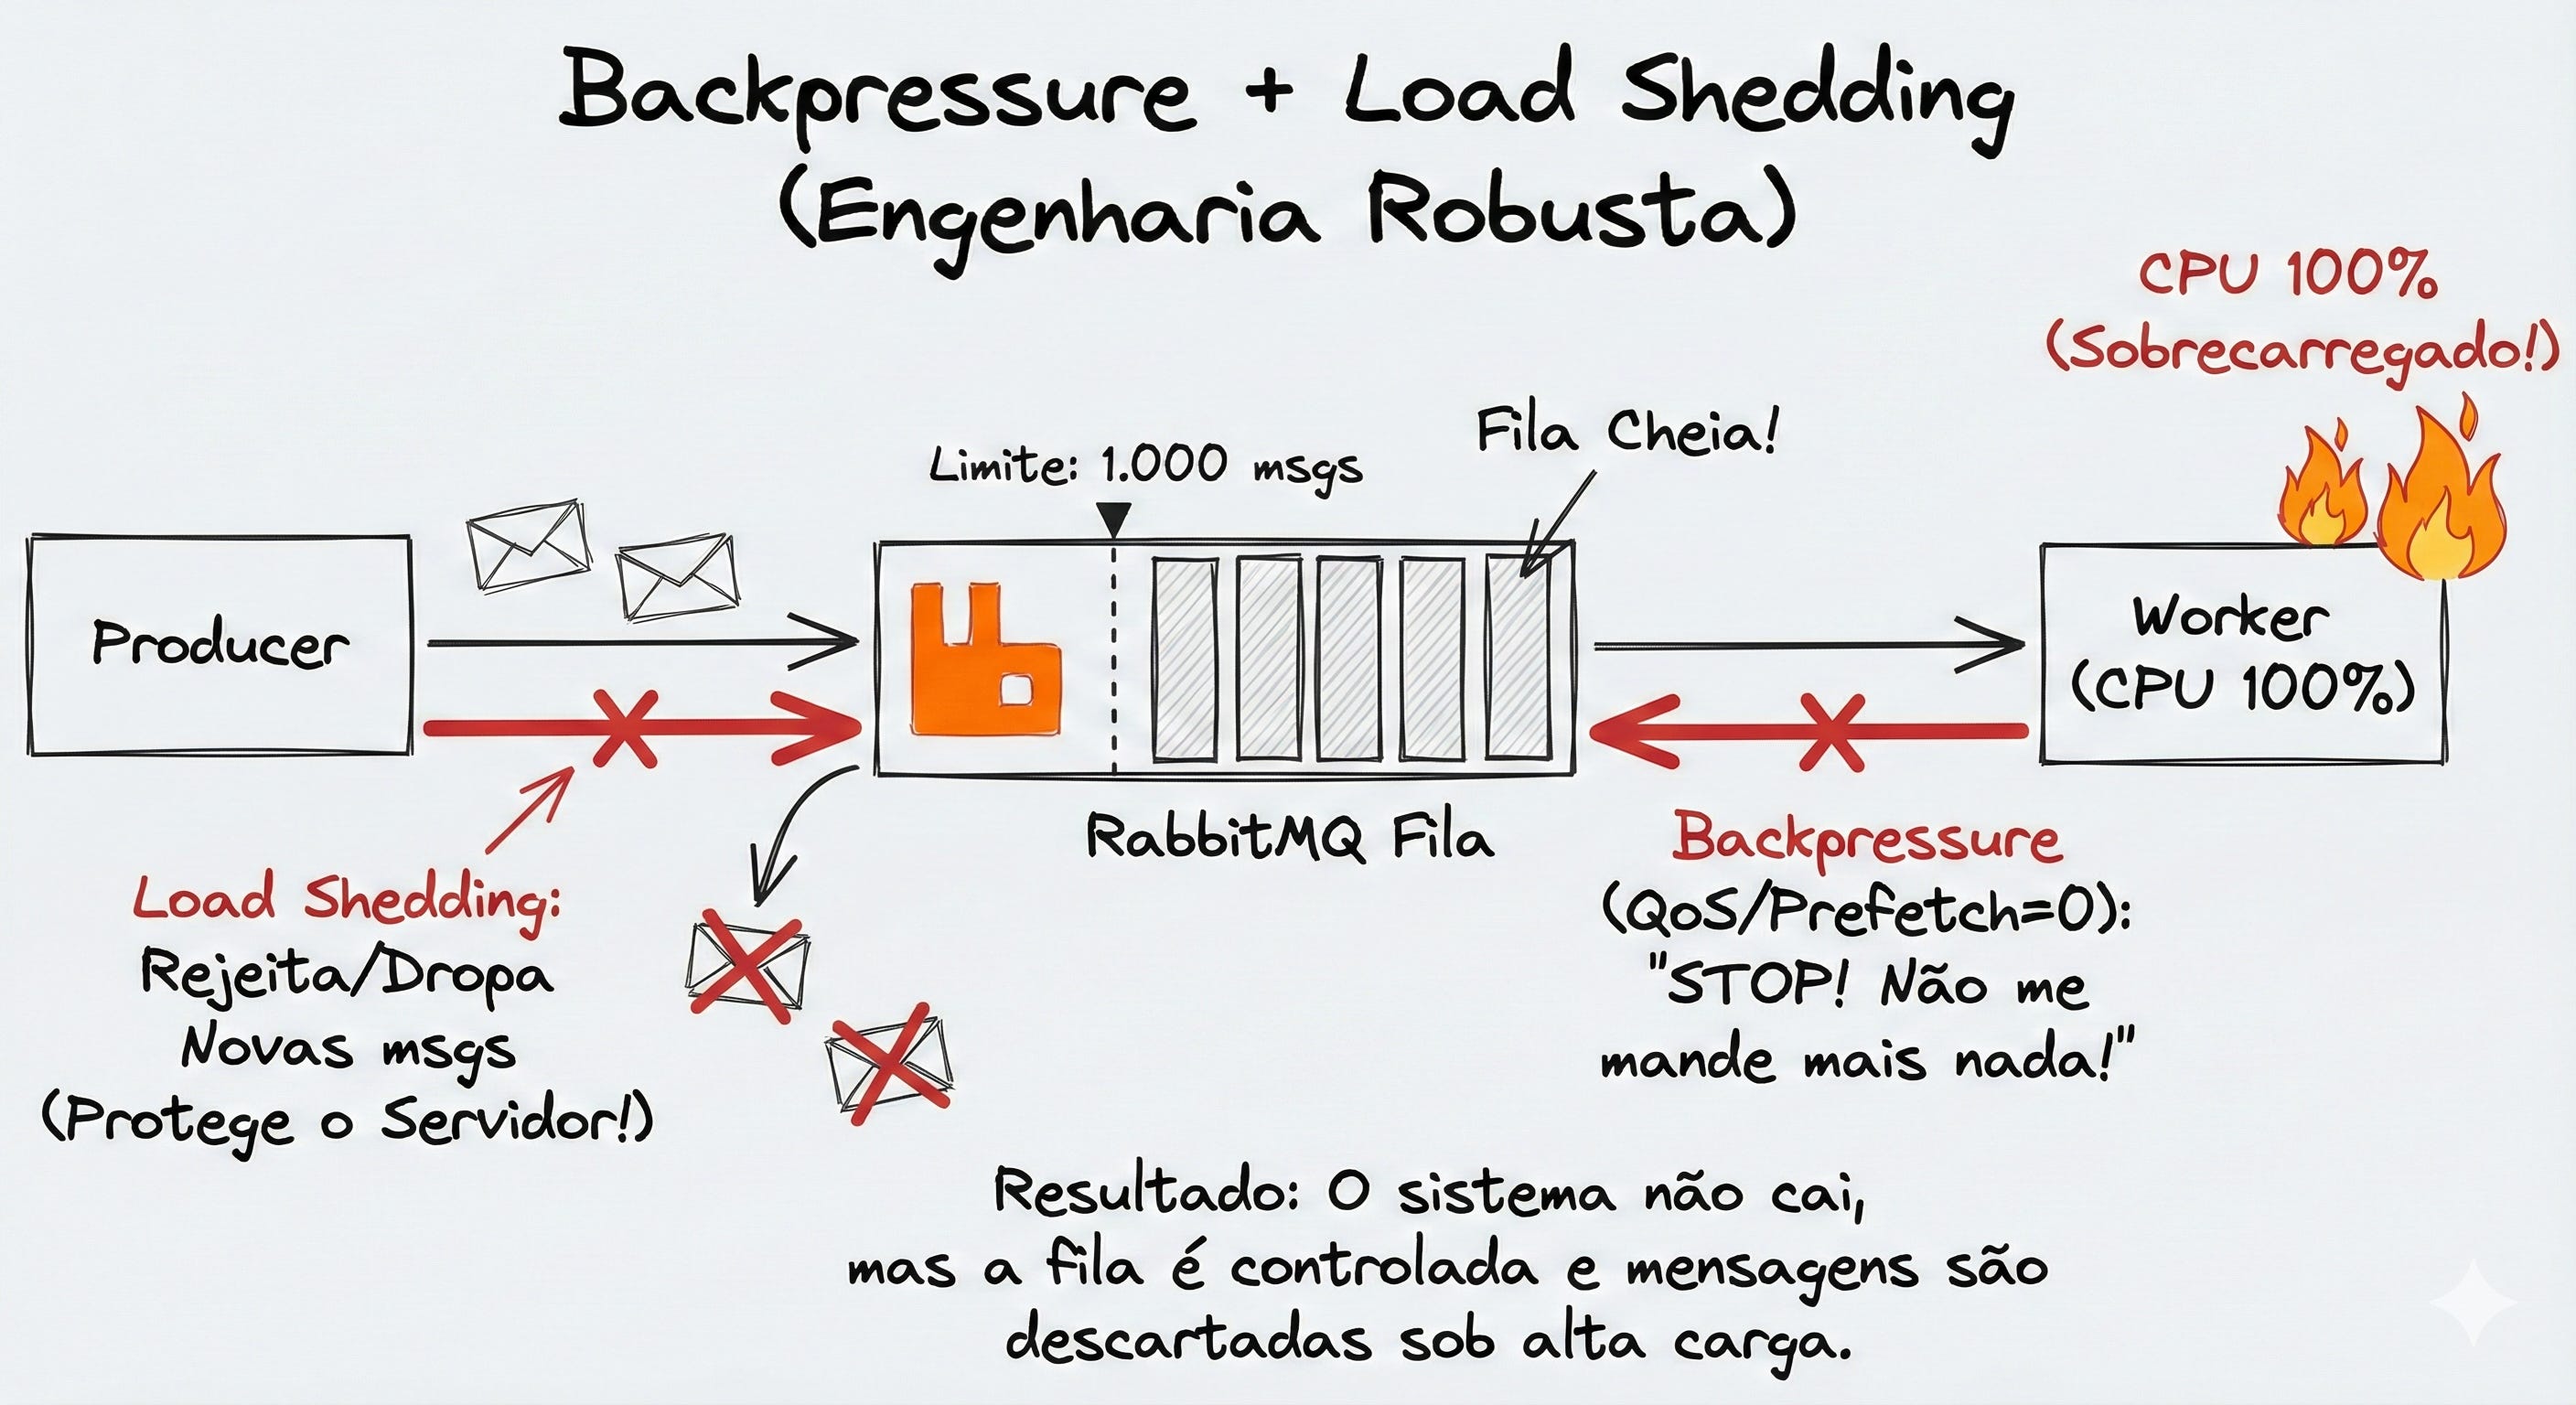
Para resolver isso, precisamos parar de ter medo de rejeitar trabalho. Engenharia robusta exige aplicar Load Shedding (Derrubar Carga) e Backpressure (Contrapressão).
1. Limite o Buffer (Bounded Queues)
Baseado no artigo do RabbitMQ, podemos limitar o tamanho da fila com base no tempo máximo tolerável.
Se seu timeout é 5s e você processa em 0.1s:
Configure sua fila (x-max-length no RabbitMQ ou buffer channel no Go) para 50.
Se chegar a 51ª mensagem: Rejeite na entrada.
É melhor retornar um erro 503 Service Unavailable em 10 milissegundos (permitindo que o cliente tente outro servidor ou mostre um aviso amigável) do que aceitar a requisição e deixá-la apodrecer por 8 minutos.
2. Use QoS e Prefetch (Backpressure)
No lado do consumidor, nunca use configurações que “puxam tudo” (unlimited prefetch). Isso transfere o buffer do Broker para a RAM da aplicação, causando Out of Memory.
Configure o basic.qos (prefetch count) para um número pequeno (ex: 10 ou 20). Isso sinaliza ao RabbitMQ: “Só me mande mais trabalho quando eu terminar esse”. Isso mantém a fila no disco do Broker, não na memória volátil da aplicação.
3. Time-To-Live na Mensagem
Uma defesa final contra zumbis é configurar um TTL nas mensagens. Se a mensagem ficar na fila por mais de 10 segundos (seu timeout de negócio), o próprio Broker a descarta ou envia para DLQ.
Assim, seu consumidor nunca desperdiça ciclos de CPU processando dados expirados.
Filas não são “armazenamento infinito gratuito”. Elas são amortecedores de choque temporários. Permitir que elas cresçam indefinidamente é uma falha de design que garante latência alta e desperdício de recursos. A verdadeira resiliência vem de saber processar o que é possível e rejeitar o que não é, mantendo o sistema responsivo para quem ainda pode ser atendido.2
Head-of-Line Blocking
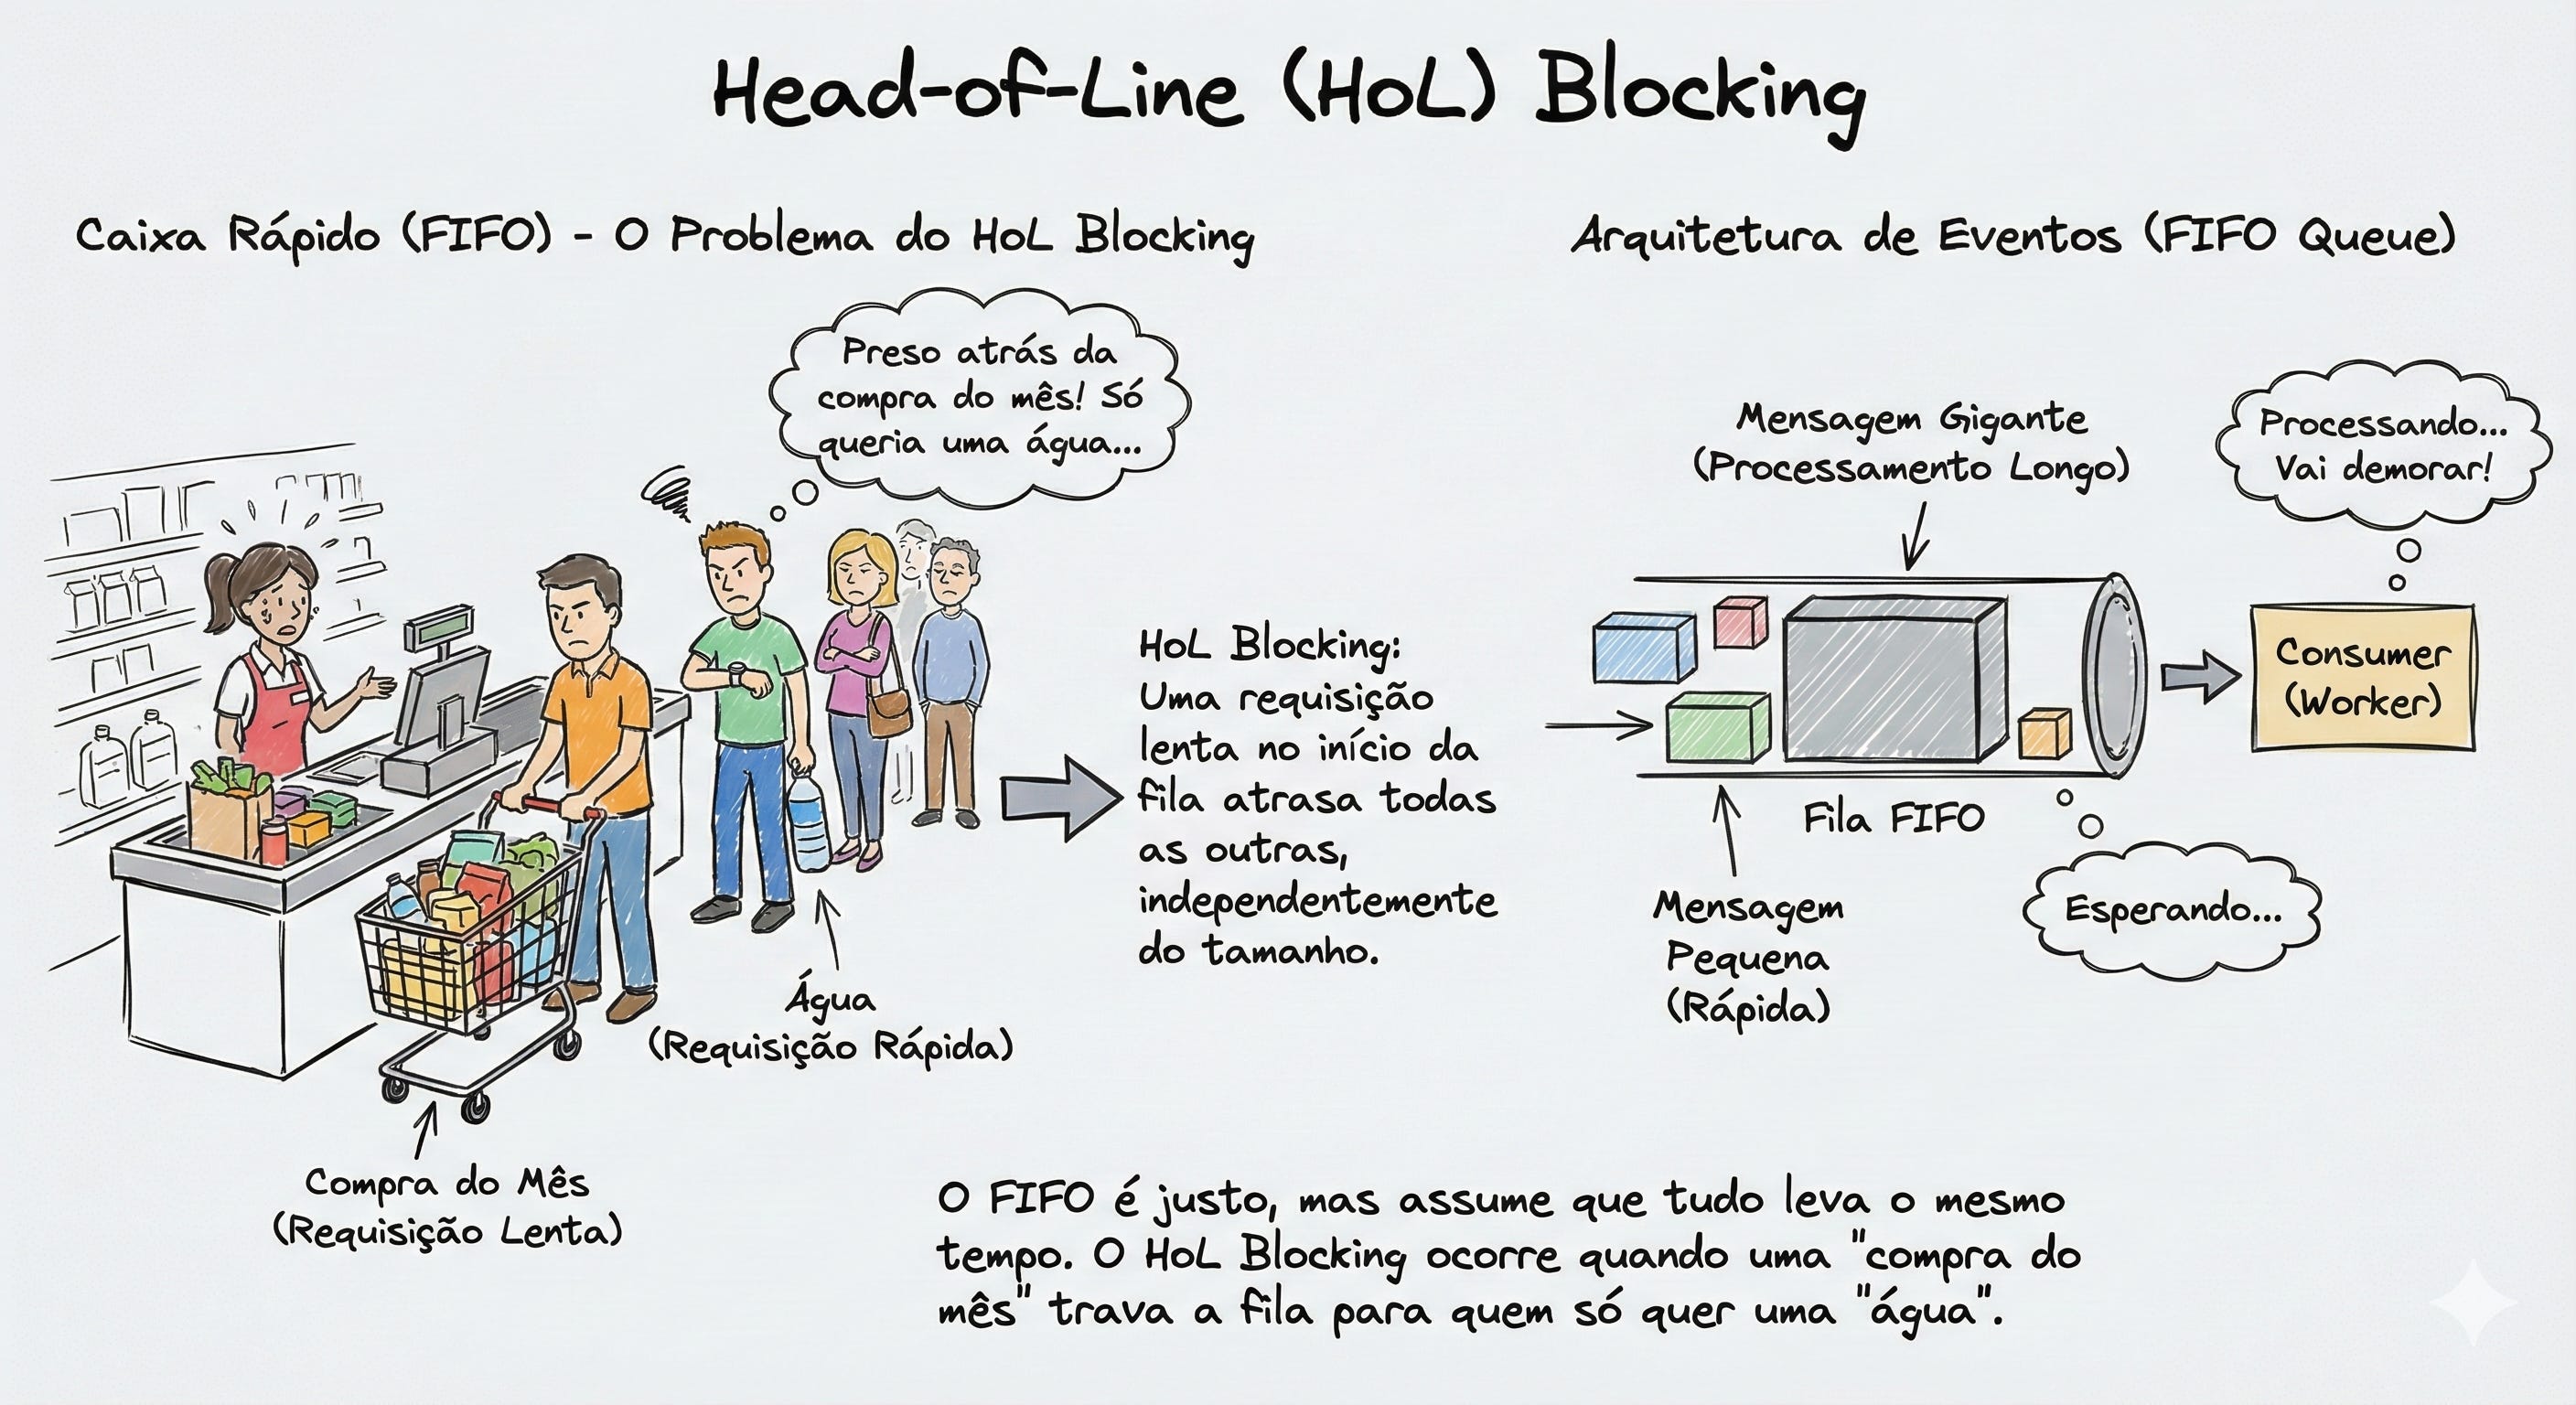
Se você já foi ao supermercado comprar apenas uma garrafa de água e acabou preso atrás de alguém fazendo a compra do mês com dois carrinhos cheios, você já sofreu de Head-of-Line (HoL) Blocking.
Em arquitetura de eventos, nós amamos filas FIFO (First-In, First-Out - O primeiro que entra é o primeiro que sai). É justo, é previsível.
Mas o FIFO tem uma falha fatal: ele assume que todas as requisições consomem o mesmo tempo.
O Problema na Prática
Imagine que você tem um tópico no Kafka chamado processamento-pagamentos.
Lá dentro, você mistura dois tipos de eventos:
Pagamento Pix (Tipo A): Rápido. Leva 50ms para processar.
Fechamento de Relatório Contábil (Tipo B): Pesado. Leva 5 segundos para processar.
Se um lote de 100 “Relatórios” entrar na fila, e logo atrás vier um “Pix”, o Pix vai ter que esperar 500 segundos (100 $\times$ 5s) apenas para chegar a vez dele.
Para o usuário do Pix, o sistema travou.
Isso é o Bloqueio da Cabeça da Fila. As tarefas rápidas estão reféns das tarefas lentas que estão na frente (”Head”).
Na engenharia, chamamos essa tarefa lenta de “Noisy Neighbor” (Vizinho Barulhento). Ele monopoliza o worker e degrada a performance de todo mundo que mora na mesma fila.
Sharding
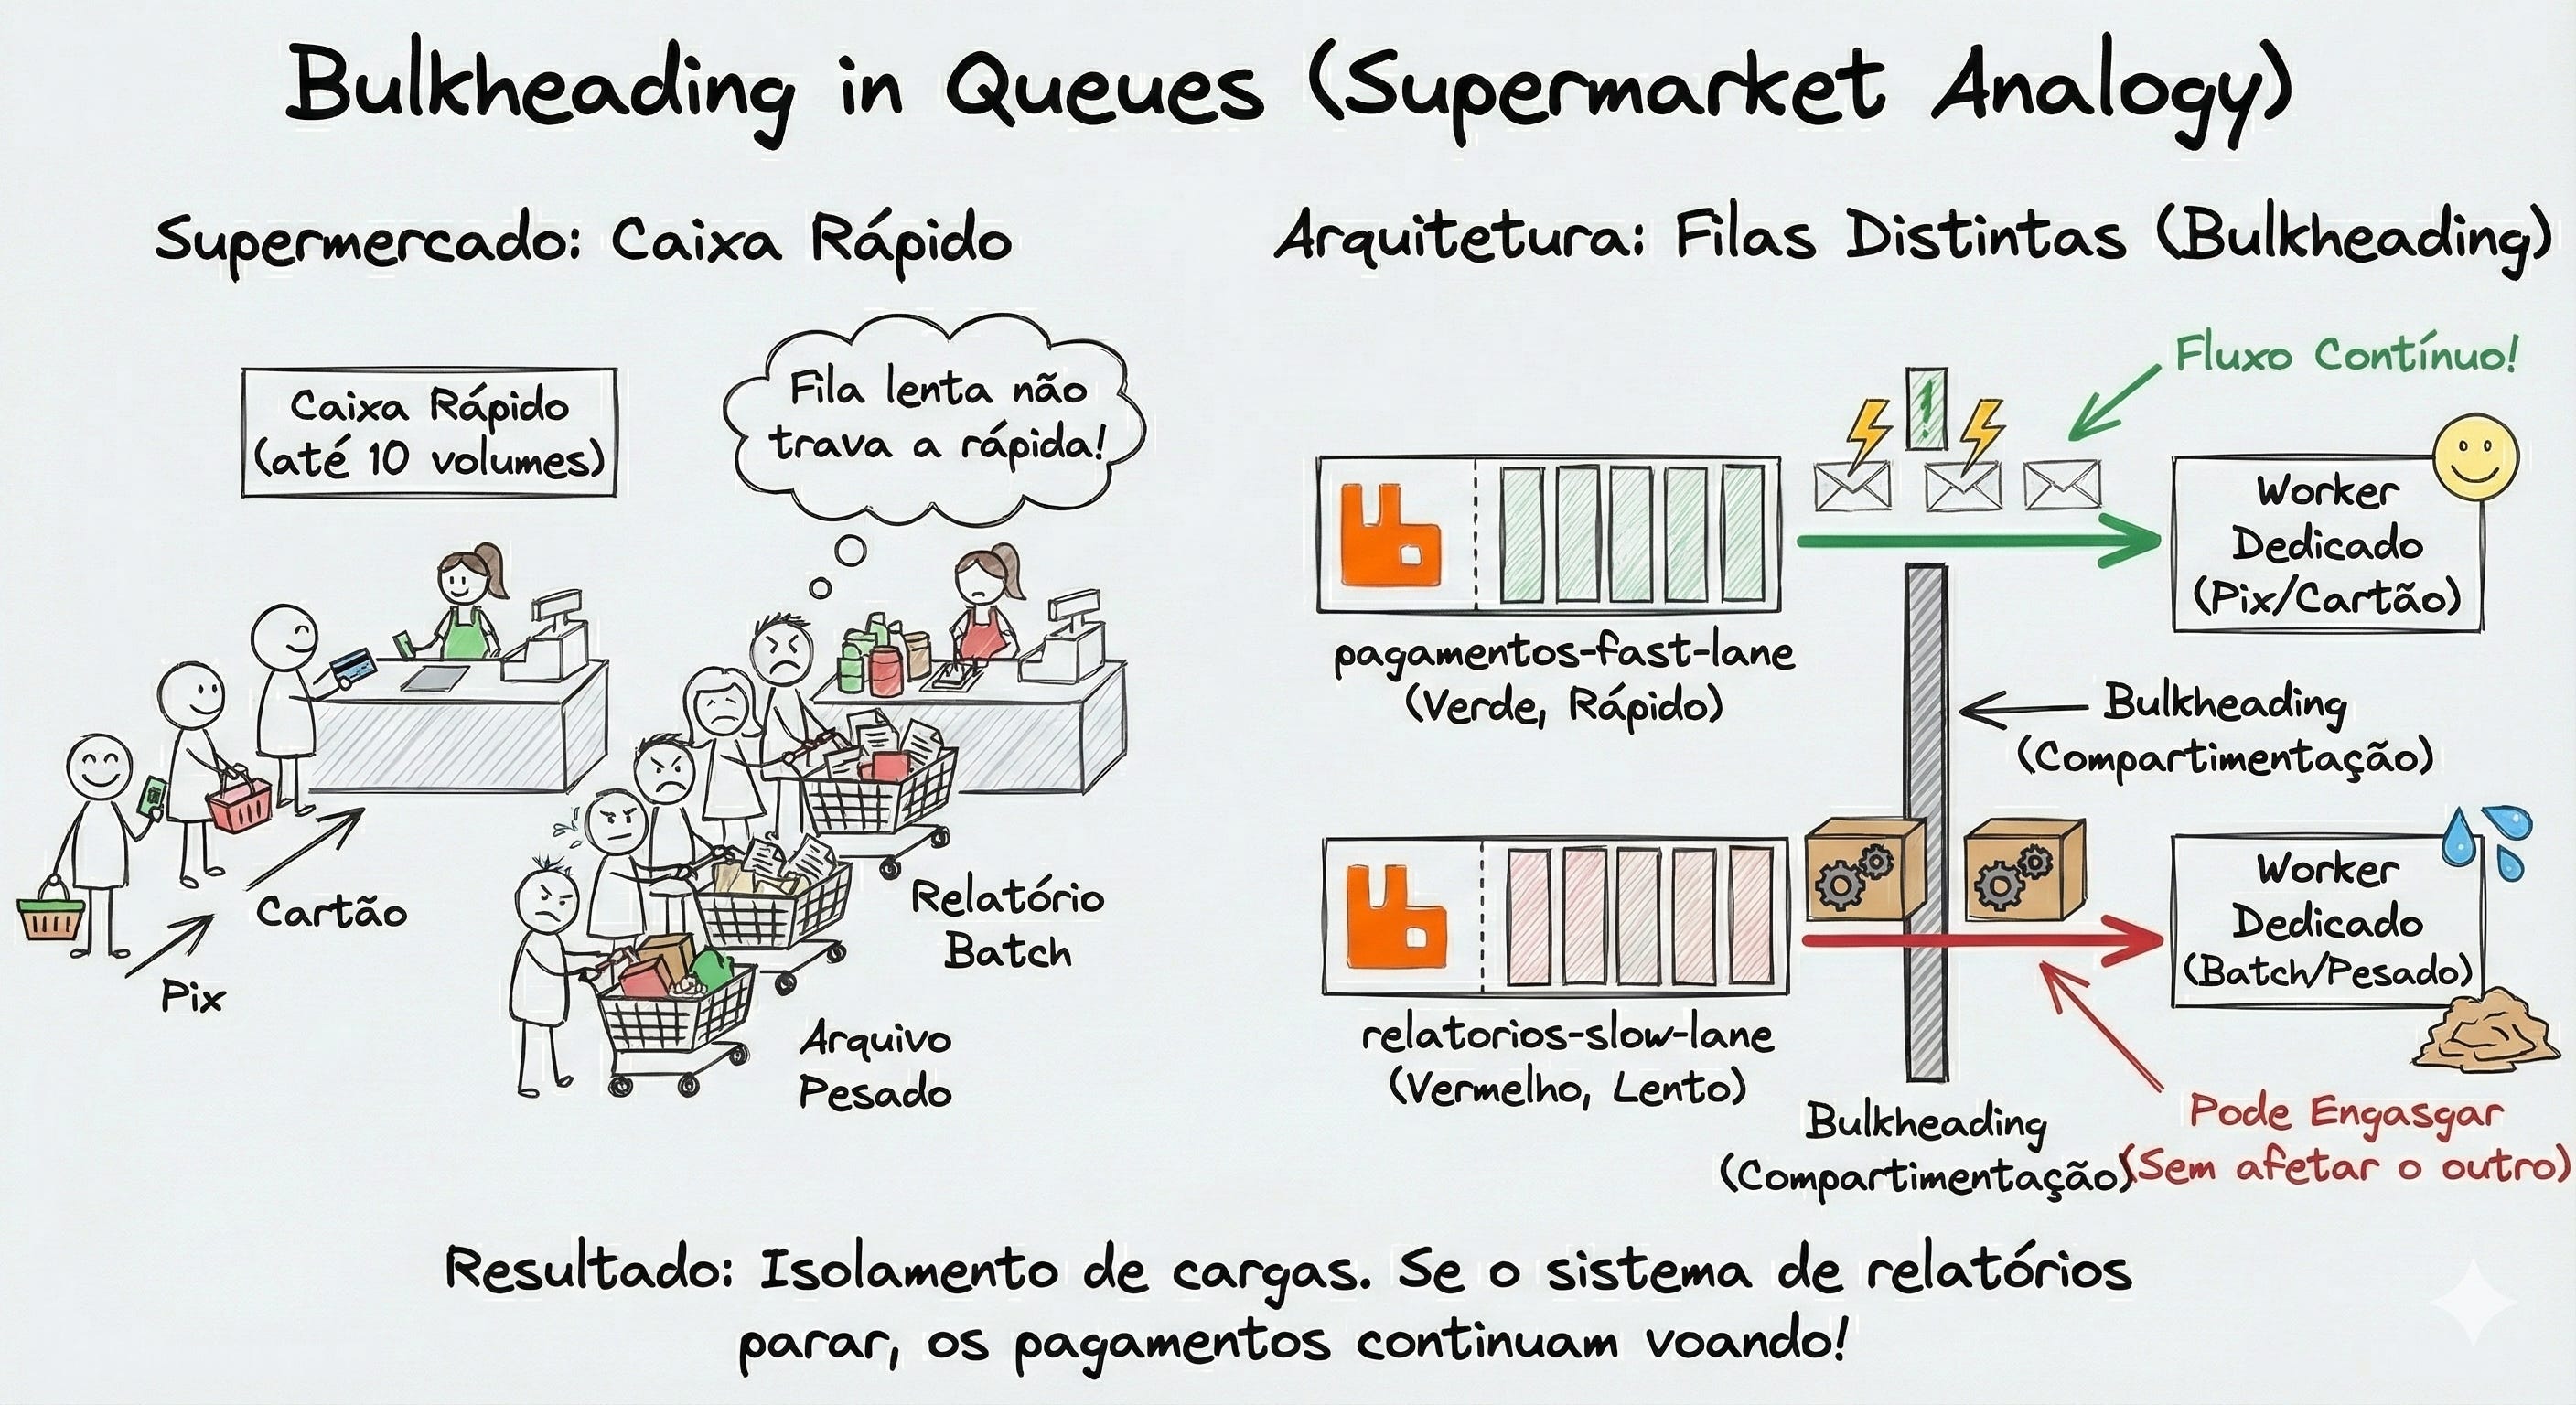
Como o supermercado resolve isso? Caixa Rápido (até 10 volumes).
Na arquitetura, fazemos o mesmo. Não misture cargas heterogêneas no mesmo tópico.
Se você tem processos leves e pesados, crie filas distintas:
pagamentos-fast-lane: Só para Pix e Cartão.relatorios-slow-lane: Só para batch e arquivos pesados.
Aloque workers dedicados para cada fila. Assim, se o sistema de relatórios engasgar, o Pix continua voando. Isso é Bulkheading (compartimentação) aplicado a filas.
O Efeito “Thundering Herd”: Por que consertar o servidor pode derrubá-lo de novo
Chegamos ao pesadelo final da arquitetura distribuída. É aquele momento em que você resolve o problema raiz, mas, paradoxalmente, essa solução causa um colapso ainda maior.
Imagine a cena clássica de “Sexta-feira à noite”: O banco de dados principal caiu. O DBA está trabalhando freneticamente para reiniciá-lo. Enquanto isso, sua arquitetura orientada a eventos está fazendo exatamente o que foi projetada para fazer: resiliência. Os Producers continuam vendendo, os usuários continuam clicando, e o Kafka/RabbitMQ está absorvendo esse impacto, acumulando mensagens.
A fila, que normalmente opera com 100 mensagens (quase real-time), agora tem 500.000 mensagens represadas. Seus 50 microsserviços (Consumers) estão rodando, mas estagnados. Eles pegam uma mensagem, tentam conectar no banco, recebem timeout, devolvem a mensagem para a fila (Nack) e tentam de novo.
Finalmente, no Slack, alguém digita a frase fatal:
“O Banco reiniciou! Podem liberar o tráfego!”
Dois segundos depois, o banco cai novamente. Desta vez, o travamento é tão severo que o servidor nem responde ao SSH. Você acabou de ser atropelado pelo Efeito Manada (Thundering Herd Problem).
A Física do Colapso: Por que o Banco “Frio” é Frágil?
Para entender por que isso acontece, precisamos analisar o estado físico do seu banco de dados no momento do reboot.
Um banco de dados em operação normal é “quente”. Suas páginas de dados mais acessadas estão na memória RAM (Buffer Pool), seus planos de execução de query estão cacheados e o pool de conexões está estável. Um banco que acabou de reiniciar é “frio”.
Caches Vazios: Toda query precisa ir buscar dados no disco físico (I/O), que é 100x mais lento que a RAM.
Overhead de Conexão: Aceitar uma nova conexão TCP e autenticar um usuário custa CPU.
No exato milissegundo em que o banco volta online, seus 50 consumers (que estavam em loop de retry) percebem simultaneamente que a porta 5432 abriu. Eles olham para a fila de 500.000 mensagens e entram em modo de pânico: “Tenho trabalho atrasado!”.
Todos os 50 consumers, rodando talvez 20 threads cada (1.000 threads no total), tentam abrir conexões e disparar INSERTs complexos ao mesmo tempo. O banco, que ainda está tentando carregar o sistema operacional, recebe um golpe de aríete de 1.000 requisições simultâneas exigindo I/O de disco. A CPU bate 100% instantaneamente, os locks de tabela travam tudo e o banco morre sufocado antes mesmo de processar a primeira query.
A Solução 1: “Slow Start”
Para evitar isso, precisamos impedir que os consumers operem em capacidade máxima imediatamente após uma falha. Precisamos de um “aquecimento”.
Na engenharia de redes, existe um algoritmo famoso no protocolo TCP/IP chamado TCP Slow Start (Partida Lenta). Quando seu computador conecta no Google, ele não sabe a velocidade real da sua internet. Se ele enviar todos os pacotes de uma vez, ele pode congestionar a rede e perder tudo. Como o TCP resolve: Ele envia 1 pacote. Se chegar o Ack (confirmação), ele envia 2. Se chegarem, envia 4, depois 8, crescendo exponencialmente até encontrar o limite da banda.
Aplicando aos seus Consumers: Devemos roubar essa ideia. Quando seu sistema detecta que o banco voltou (após um período de erro), o consumer não deve processar o prefetch máximo (ex: 50 msgs). Ele deve entrar em modo Slow Start:
Fase 1: Processe apenas 1 mensagem. Espere 1 segundo. Sucesso?
Fase 2 : Processe 5 mensagens. Sucesso?
Fase 3: Volte para a capacidade total.
Isso dá ao banco de dados os preciosos segundos necessários para popular o cache da memória RAM e estabilizar as conexões, transformando um “tsunami” em uma “maré que sobe devagar”.
A Solução 2: Jitter
O segundo problema é a Sincronia Artificial. Computadores são relógios perfeitos. Se você programou seus consumers para tentar reconectar a cada 5 segundos (retry_interval = 5000ms), o que acontece?
Consumer A bate no banco às 10:00:05.000
Consumer B bate no banco às 10:00:05.000
Consumer C bate no banco às 10:00:05.000
Eles formam uma onda de choque periódica. Mesmo que o banco aguente a média, ele não aguenta o pico sincronizado.
Para quebrar essa sincronia, introduzimos o Jitter (Ruído/Aleatoriedade). Nunca use tempos fixos em sistemas distribuídos. A fórmula de espera deve ser:
Exemplo: 5000ms + Random(0, 1000ms).
Consumer A tenta em 5.1s
Consumer B tenta em 5.4s
Consumer C tenta em 5.8s
Parece uma mudança boba, mas matematicamente, isso “espalha” a carga ao longo do tempo. Em vez de 1.000 marteladas num único milissegundo, você tem uma “chuva” constante de requisições distribuídas ao longo de um segundo inteiro.
O Efeito “Thundering Herd” nos ensina que recuperar um sistema é tão perigoso quanto a queda dele. Se seus consumidores são gananciosos e tentam limpar a fila o mais rápido possível assim que a dependência volta, eles agem como um ataque DDoS não intencional (Friendly Fire).
Implementar Slow Start e Jitter não é sobre deixar o sistema lento; é sobre moderação estratégica. Às vezes, para ir rápido (limpar a fila), você precisa, obrigatoriamente, começar devagar.
Como implementar Jitter e Slow Start na vida real
Falar de “algoritmos de TCP” é fascinante, mas você não vai reescrever o kernel do Linux dentro do seu microsserviço Java ou Node.js. Como trazemos essa física para a nossa arquitetura de eventos de forma pragmática?
Caminho 1: O “Jitter” está nas Bibliotecas de Resiliência (Não faça na mão!)
Você não precisa escrever Thread.sleep(Random.Next()). Isso é amador e difícil de testar. A indústria já resolveu isso com o padrão Exponential Backoff with Jitter.
A maioria das linguagens modernas possui bibliotecas de resiliência robustas que já trazem isso pronto. Seu trabalho é configurar, não codar.
No mundo .NET: Use o Polly. Ele tem uma política nativa:
WaitAndRetryAsynccomBackoffType.Exponentiale, crucialmente, uma contribuição deJitter.No mundo Java: Use o Resilience4j. Configure o
IntervalFunction.ofExponentialRandomBackoff().No mundo Python: Use o Tenacity. Configure
wait=wait_random_exponential(multiplier=1, max=60).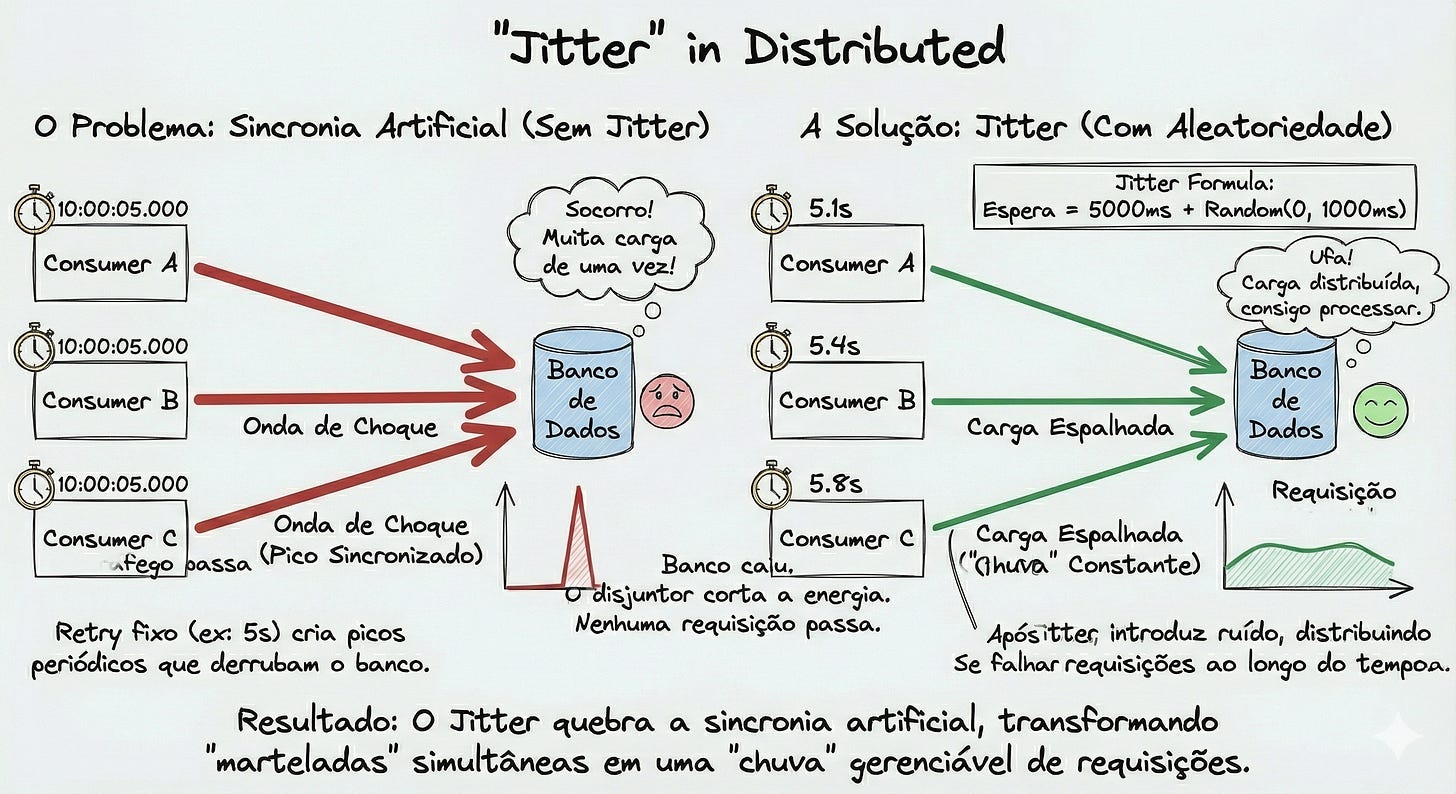
O que acontece na prática: Quando o banco falha, a biblioteca assume o controle. Ela calcula matematicamente: “Vou tentar em 2.1s... falhou. Agora em 4.3s... falhou. Agora em 8.7s”. Isso garante o espalhamento da manada sem você escrever uma linha de lógica matemática.
Caminho 2: Implementando “Slow Start” com Circuit Breaker (O Estado “Half-Open”)
O padrão Circuit Breaker (Disjuntor) é a implementação mais realista do conceito de Slow Start para 90% das aplicações.
Imagine o Circuit Breaker como um interruptor inteligente entre seu Consumer e o Banco de Dados.
Estado Fechado (Closed): Tudo normal. O tráfego passa.
Estado Aberto (Open): O banco caiu. O Disjuntor “abre” e corta a energia. O Consumer para de tentar bater no banco instantaneamente (fail fast).
O Pulo do Gato: Estado Meio-Aberto (Half-Open): Após um tempo (ex: 30s), o disjuntor não fecha de vez. Ele entra em modo “Meio-Aberto”. Ele permite que apenas uma requisição (ou um número muito pequeno) passe. É a “Sonda”.
Se essa requisição falhar: Ele abre de novo imediatamente.
Se essa requisição tiver sucesso: Ele fecha e libera o fluxo total.
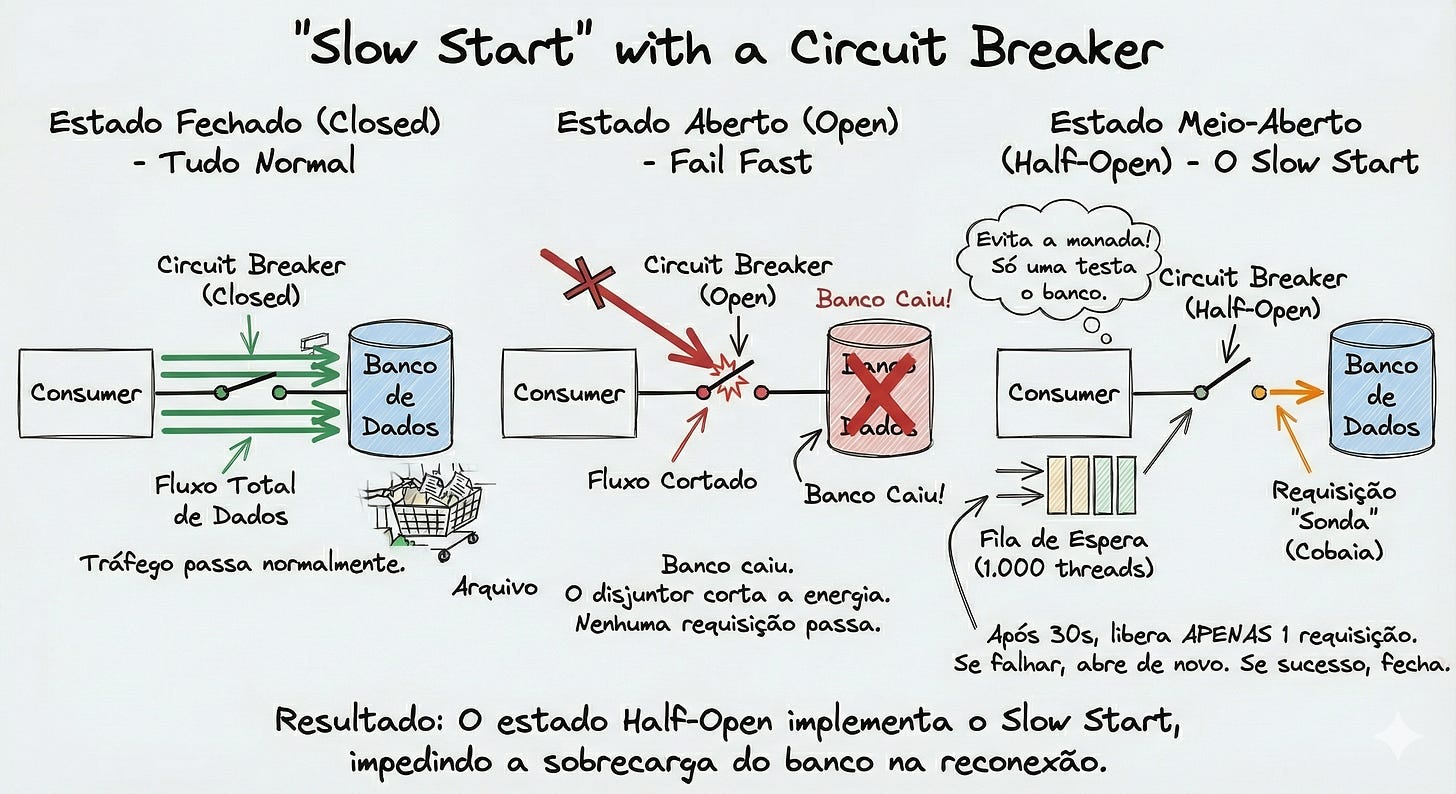
Por que isso resolve? O estado Half-Open é o Slow Start. Ele impede que as 1.000 threads tentem reconectar simultaneamente. Apenas uma “cobaia” testa o banco. Se o banco ainda estiver frio ou caindo, só uma requisição falha, não a manada inteira.
Caminho 3: Slow Start via Controle de Vazão (Reinicialização Estratégica)
Se sua biblioteca não permite mudar o prefetch com o carro andando (a maioria exige reinicializar o consumidor), use a estratégia de Pause & Resume.
Detector de Pânico: Ao capturar exceções consecutivas do banco, seu código pausa o Listener (ex:
listener.stop()no Spring ouconsumer.pause()no Kafka).Reconfiguração: Altere a configuração do prefetch para 1 na memória.
Religar: Reinicie o Listener. Ele voltará consumindo 1 mensagem por vez.
Rampa: Conforme os erros somem, reinicie o listener novamente com prefetch 10, depois 50.
Embora pareça agressivo “parar e voltar”, isso é infinitamente melhor do que deixar o consumidor bater no banco 1.000 vezes por segundo.
Kubernetes e Auto-Scaling
Cuidado com o “Fogo Amigo” da infraestrutura. Se você usa KEDA (Kubernetes Event-driven Autoscaling), ele vai ver a fila de 500.000 mensagens e tentar subir 100 Pods de uma vez. Isso é o oposto de Slow Start.
A Solução: Configure janelas de estabilização (stabilization windows) no HPA (Horizontal Pod Autoscaler) ou limites de velocidade de scale-up. Obrigue o Kubernetes a subir novos pods devagar, dando tempo para o banco “respirar” antes de ter 100 instâncias novas atacando ele.
Resumo
Não tente reinventar a matemática.
Use Bibliotecas de Resiliência para o Jitter (Polly, Resilience4j).
Use Circuit Breakers para o controle de fluxo “Tudo ou Nada” com segurança (Half-Open).
Use Controle de Prefetch se precisar de uma rampa suave e personalizada.
Implementar isso é a diferença entre um sistema que cai e volta sozinho, e um sistema que precisa ser reiniciado manualmente às 3 da manhã porque entrou em loop de autodestruição.
A Grande Ilusão: Desacoplamento Espacial vs. Acoplamento Temporal
Antes de encerrarmos, precisamos destruir o mito mais perigoso sobre Arquitetura Orientada a Eventos: A ideia de que filas resolvem todos os problemas de dependência.
Quando você troca uma chamada HTTP síncrona (REST) por uma mensagem assíncrona (Kafka/RabbitMQ), você ganha Desacoplamento Espacial.
Significado: O serviço A não precisa saber o IP do serviço B, nem se o serviço B está online naquele exato segundo. Se o B cair, o A continua aceitando pedidos. Isso é ótimo.
Mas o que os vendedores de cursos esquecem de avisar é que você acabou de criar um Acoplamento Temporal.
O Que é Acoplamento Temporal?
Mesmo que os serviços não estejam conectados por um cabo de rede direto, eles estão conectados pelo fluxo de dados. Se o seu Producer (Vendas) gera 1.000 eventos por segundo, e o seu Consumer (Nota Fiscal) só processa 500, o sistema está logicamente quebrado.
O cliente comprou, mas a nota não sai.
O produto saiu do estoque, mas o site ainda mostra disponível.
Você trocou um “Erro 500” (que é visível e barulhento) por um “Lag de 4 horas” (que é silencioso e mortal).
Os Gargalos Silenciosos
Em REST, se o sistema fica lento, o cliente reclama na hora (Latência alta). Em Eventos, se o sistema fica lento, a fila absorve o impacto silenciosamente (Lag). O gerente olha o dashboard: “CPU ok, Memória ok, Zero erros”. Enquanto isso, o negócio está sangrando. Dados estão ficando obsoletos (Stale Data) e decisões estão sendo tomadas com base em informações velhas.
Por que a Teoria das Filas é o Pré-Requisito?
É por isso que estudar Teoria das Filas não é um preciosismo acadêmico; é um pré-requisito de sobrevivência.
Se você implementa RabbitMQ ou Kafka sem entender a Lei de Little ou a Fórmula de Kingman, você está pilotando um avião no meio da neblina sem altímetro.
Você acha que está voando alto (fila aceitando tudo), mas está a segundos de bater na montanha (Bufferbloat e OOM).
Você acha que adicionar mais consumidores resolve tudo, mas não previu o Thundering Herd que vai derrubar seu banco de dados.
Arquitetura Orientada a Eventos é poderosa, mas ela exige maturidade matemática. Antes de dar docker run rabbitmq, entenda que você não está apenas subindo um container; você está introduzindo um componente probabilístico e estocástico na sua infraestrutura. Se você não souber calcular os limites dele, ele vai definir os limites do seu negócio — da pior maneira possível.
Conclusão
Ao longo deste artigo, viajamos de Copenhague em 1909 (com Agner Erlang) até os Data Centers modernos distribuídos em Kubernetes. Passamos por fórmulas matemáticas, curvas exponenciais e estratégias de defesa como Load Shedding e Jitter.
Mas o que, de fato, podemos levar para a nossa próxima Daily ou Architecture Review?
A lição fundamental é que ferramentas não resolvem problemas de física. Você pode usar o broker mais rápido do mundo (Kafka, Redpanda, RabbitMQ), escrito em Rust, Go ou C++. Nada disso importa se você violar a Lei de Little ou ignorar a Fórmula de Kingman. Se a taxa de chegada for maior que a de saída, ou se a utilização roçar os 100%, a latência vai subir, a memória vai estourar e o sistema vai colapsar. A matemática é implacável; você não negocia com ela.
A diferença entre um programador sênior e um verdadeiro arquiteto de software não está em saber decorar a API do RabbitMQ. Está em entender que:
Filas Infinitas são uma Mentira: A memória é finita e a paciência do usuário é curta. Aceitar trabalho que você não pode entregar a tempo (Bufferbloat) não é resiliência, é negligência. A coragem de dizer “Não” (rejeitar carga) é o que salva o sistema.
O “Happy Path” é Irrelevante: Qualquer sistema funciona quando tudo vai bem. A engenharia de verdade acontece no caos: quando o banco cai, quando a Manada Estourada volta, quando o Vizinho Barulhento entope o tópico. Projetamos para a falha, não para o sucesso.
Observabilidade é Obrigatória: Você não pode corrigir o “Joelho da Curva” se não souber onde ele está. Métricas de Consumer Lag, Processing Time e Error Rate não são “bônus”, são os batimentos cardíacos da sua aplicação.
Arquitetura Orientada a Eventos é poderosa, mas perigosa. Ela nos dá a ilusão de desacoplamento infinito, mas esconde acoplamentos temporais e gargalos silenciosos.
Ao desenhar seu próximo microsserviço, lembre-se: resiliência não é algo que você instala via npm install ou docker run. Resiliência é o resultado de decisões matemáticas conscientes.
“Dizer que o tráfego é ‘rajado’ (bursty) significa que a carga de trabalho chega em picos imprevisíveis e violentos, seguidos de períodos de calmaria. É o oposto de um fluxo constante. É por isso que dimensionar servidores baseando-se na ‘média de requisições’ é um erro fatal: a média esconde os picos, e são os picos que derrubam sua aplicação.”
Você deve estar se perguntando: “Ok, entendi que a fila enche. Mas qual é a diferença prática entre derrubar a carga e fazer contrapressão? Eu uso um ou o outro?”
A resposta de engenharia robusta é: Você usa os dois juntos. Eles são o freio e o cinto de segurança do seu sistema.
Para visualizar, imagine o seguinte.
Backpressure (Contrapressão): É o sinal de pare. Quando o Consumer (sua aplicação) diz: “Estou engasgado, pare de me mandar água!”. No RabbitMQ, isso é feito via
QoS / Prefetch. O Consumer para de buscar mensagens e elas começam a acumular na Fila. O objetivo aqui é proteger a Aplicação de travar por falta de memória.Load Shedding (Derrubar Carga): É a válvula de escape. Como a contrapressão fez a água acumular na Fila, agora a Fila está perigosamente cheia. Se continuar entrando água, o Broker (RabbitMQ) vai explodir. O Load Shedding entra em ação para abrir uma válvula e jogar o excesso fora (no lixo ou DLQ) antes que o reservatório estoure. O objetivo aqui é proteger o Broker e a Latência.
Como eles trabalham juntos
O Worker fica sobrecarregado (CPU 100%).
Ele aplica Backpressure no RabbitMQ (via configuração de QoS/Prefetch), dizendo: “Não me mande mais nada até eu terminar este lote”.
Como o RabbitMQ parou de entregar para o Worker, as mensagens começam a empilhar na Fila.
A Fila atinge seu limite máximo (ex: 1.000 msgs).
O RabbitMQ aplica Load Shedding: Como a fila está cheia e o Worker não aceita mais nada, o RabbitMQ começa a rejeitar/dropar as novas mensagens que chegam do Producer (ou joga as mais antigas fora), salvando o servidor de cair.
Uma verdadeira aula de forma escrita e detalhada, genial este artigo!
Rafael muito obrigado por esse artigo. Ele ordena o caos conceitual.